이 글에서 살펴볼 내용

SXSSF를 사용해도 입력 List와 출력 버퍼에서 OOM이 발생할 수 있다. 같은 데이터로 네 가지 구현을 비교하며 메모리가 필요한 지점을 살펴본다.

6개월치 매출을 다운로드하면 서버가 멈췄다

이전에 운영하던 CMS에서 OOM 문제가 발생했다. 애플리케이션 로그에는 엑셀 다운로드 실행 이후 오류가 남았고, 다른 부서에서도 다운로드 이후 서버가 반응하지 않았다는 이야기를 들었다.

짧은 기간의 다운로드는 문제가 없었지만 6개월 이상 매출을 내려받을 때 문제가 나타났다. 금요일 저녁과 주말 결제 집중 시간대에도 OOM이 발생했다.

당시에는 리전별 EC2 사양을 확인해 JVM 메모리 설정을 조정하고, GPT의 도움으로 다운로드 코드를 분석해 XSSF를 SXSSF로 변경했다. 두 조치 이후 퇴사 시점까지 OOM은 재발하지 않았다.

다만 두 조치를 함께 적용했기 때문에 각각의 효과를 분리해서 측정한 것은 아니다. 이번 글에서는 당시 경험에서 출발해, SXSSF를 사용해도 OOM이 발생할 수 있는 두 지점을 살펴본다.

실험 코드 작성과 로컬 실행·결과 확인에는 AI 도구의 도움을 받았다. 운영 코드나 실제 매출 데이터 대신 별도의 가상 데이터를 사용했다.

엑셀 객체 앞뒤에도 데이터가 있다

다운로드 코드를 세 단계로 나누어 보았다.

처리 흐름 / 로그
입력 데이터 보관 → 엑셀 행과 셀 생성 → 완성 파일 출력
     List             Workbook          Stream 또는 byte[]

SXSSF는 일정 범위의 행을 메모리에 유지하고 오래된 행을 임시파일로 넘기는 방식이다. 그러나 입력 List나 출력 버퍼까지 관리해 주는 것은 아니다.

따라서 new SXSSFWorkbook(100)의 100은 애플리케이션 전체가 보관하는 데이터 수나 메모리 용량의 상한이 아니다. Apache POI 공식 안내

비교할 지점은 두 가지다.

  • 전체 입력을 먼저 List에 담으면 SXSSF를 사용해도 입력 단계에서 실패할 수 있다.
  • 입력을 나누어 처리하더라도 출력 파일 전체를 메모리에 모으면 출력 단계에서 실패할 수 있다.

실험 조건

실제 매출이나 운영 DB 대신 가상 매출 데이터를 사용했다. 같은 id에는 같은 메모 문자열이 생성되므로 모드가 달라도 입력값은 같다. 메모는 영문과 숫자를 섞어 생성했고, 행별로 동일한 문자를 반복해 파일이 지나치게 잘 압축되는 상황을 피했다.

항목 조건
실행 환경 로컬 Java 21.0.1, Apache POI 5.2.3
GC 및 힙 G1 GC, -Xms96m -Xmx96m
데이터 50,000행, 행당 메모 2,048자
열 id, 매장, 금액, 메모
SXSSF 행 윈도 100
입력 페이지 1,000건
실행 방식 모드마다 별도 JVM, 순차 실행

POI 버전은 로컬에 있던 의존성을 사용해 고정했다. 최신 버전을 권장하기 위한 선택은 아니다. DB 조회는 Java 객체 생성으로 모사했으므로 JDBC 스트리밍이나 DB 성능을 검증한 실험도 아니다.

1. 전체 List를 만들면 엑셀 생성 전에 실패할 수 있다

전체 입력 모드는 다음 구조다. 아래 코드는 실습의 핵심 부분을 발췌한 것이다. Sale은 id·매장·금액·메모를 가진 가상 매출 객체, page(start, end, width)는 해당 범위의 객체를 List로 만드는 함수, append()는 객체 하나를 시트의 한 행에 쓰는 함수다.

JAVA
List<Sale> all = page(0, rows, width);
for (Sale item : all) {
    append(sheet, item);
}
Reference.reachabilityFence(all);

page(0, rows, width)가 모든 행의 객체와 문자열을 생성한다. 이 시점에는 아직 append()로 엑셀 행을 쓰기 전이다.

reachabilityFence는 실험에서 행 생성이 끝날 때까지 List가 도달 가능한 상태를 유지하도록 넣었다. GC를 실행하거나 객체를 해제하는 함수는 아니다.

5만 행 조건에서는 XSSF와 SXSSF 모두 materialize-all-input 단계에서 OOM으로 종료됐다. 엑셀 구현을 바꿔도 그 전에 만드는 입력 데이터의 크기는 그대로라는 점을 확인할 수 있었다.

이 결과로 XSSF와 SXSSF 자체의 메모리 차이를 비교할 수는 없다. Workbook 차이를 보려면 먼저 입력 List가 힙에 들어가는 조건을 만들고, 행 생성 단계까지 진행되는 별도 실험이 필요하다.

2. 입력 보관 범위도 함께 줄이기

페이지 모드는 다음과 같이 구현했다.

JAVA
for (int from = 0; from < rows; from += batch) {
    List<Sale> block = page(from, Math.min(rows, from + batch), width);
    for (Sale item : block) {
        append(sheet, item);
    }
}

한 번에 1,000건을 만들고 시트에 쓴 뒤 다음 범위로 넘어간다. 이전 페이지를 별도 List에 계속 추가하지 않는다.

이전 입력 객체는 더 이상 참조되지 않으면 회수 대상이 될 수 있다. 반복이 끝날 때마다 즉시 GC된다는 의미는 아니다.

출력도 완성 파일 전체를 앱의 byte 배열에 모으지 않고 파일 스트림에 직접 쓴다.

JAVA
try (OutputStream out = Files.newOutputStream(output)) {
    wb.write(out);
}

이 모드는 같은 5만 행 조건에서 정상 완료됐다. 입력과 행 생성 양쪽의 보관 범위를 제한하고, 출력 전체를 별도 메모리 버퍼에 쌓지 않은 구현이다. 내부 버퍼나 다른 객체의 메모리 사용까지 없어지는 것은 아니다.

3. 마지막에 파일 전체를 모으면 다시 실패한다

출력 버퍼 모드는 페이지 처리와 SXSSF를 그대로 사용하고 마지막 부분만 바꿨다.

JAVA
try (ByteArrayOutputStream buffer = new ByteArrayOutputStream()) {
    wb.write(buffer);
    byte[] bytes = buffer.toByteArray();
    Files.write(output, bytes);
}

ByteArrayOutputStream은 완성 파일을 메모리에 모은다. 이어서 toByteArray()를 호출하면 별도 배열로 복사한다. 따라서 앞 단계가 제한된 메모리로 동작해도 마지막 출력 방식에 따라 부담이 다시 커질 수 있다.

실제 큰 실험에서는 write-output 단계에서 OOM이 발생했고 buffer-plus-copy 로그는 남지 않았다.

즉, 이번 실패는 toByteArray() 복사 시점이 아니라 그 전에 wb.write(buffer)를 실행하는 도중에 발생했다. 복사본은 추가 부담이 될 수 있는 코드상의 요소지만 이번 실패 지점과는 구분해야 한다.

결과와 검증 범위

모드 결과 확인된 실패 단계
전체 List + XSSF + 파일 출력 OOM 입력 List 생성
전체 List + SXSSF + 파일 출력 OOM 입력 List 생성
페이지 처리 + SXSSF + 파일 출력 성공 —
페이지 처리 + SXSSF + 메모리 출력 버퍼 OOM 출력 버퍼에 쓰기

성공한 페이지 모드의 프로그램 내부 시간은 9.348초, 50ms 간격으로 관찰한 힙 사용량 최대는 63.10MiB였다.

출력 파일은 78,691,392바이트였고 정리 전 임시파일의 크기 합은 112,465,860바이트였다. 메모리와 함께 임시 디스크 사용도 살펴볼 필요가 있었다.

이 수치는 단일 실행 결과다. 샘플링 사이의 순간 최대값은 놓칠 수 있고, 힙 사용량은 프로세스 전체 메모리가 아니다. 시간을 일반적인 성능 수치로 제시하려면 반복 측정이 필요하다.

작은 조건인 2,000행·메모 256자·힙 128MB에서는 네 모드가 모두 성공했다. 생성된 XLSX의 XML에서 셀 값을 추출해 비교한 결과, 모두 2,000행이며 값 기준 SHA-256이 같았다.

큰 조건의 성공 파일도 50,000행임을 확인했다. 파일을 끝까지 생성했는지와 같은 데이터를 썼는지를 함께 확인한 것이다.

성공 여부만큼 실패한 단계도 중요했다

실행 기록에는 입력 생성, 엑셀 행 생성, 파일 출력의 시작 지점을 남겼다. 같은 OOM이어도 입력 List를 만드는 중에 발생했는지, 출력 버퍼를 채우는 중에 발생했는지에 따라 살펴볼 코드가 달랐다.

처리 흐름 / 로그
materialize-all-input  : 전체 입력 List 생성 시작
build-workbook        : List를 순회하며 엑셀 행 생성 시작
page-input-and-build  : 페이지별 입력 생성과 엑셀 행 생성 시작
write-output          : Workbook을 출력 스트림에 쓰기 시작
buffer-plus-copy      : 출력 버퍼를 byte 배열로 복사한 뒤
completed             : 파일 출력과 측정 완료

마지막 단계 로그는 실패 범위를 좁히는 단서다. 어떤 객체가 얼마의 메모리를 붙잡고 있는지까지 알려주지는 않는다. 이번 실험에서는 힙 덤프를 분석하지 않았으므로 객체별 점유량이나 참조 경로를 확인했다고 말할 수는 없다.

후속으로는 힙 덤프의 Dominator Tree와 GC Root 참조 경로를 살펴보면 좋겠다. 코드에서 예상한 List·문자열·출력 버퍼의 생존 범위가 실제로도 그렇게 나타나는지 확인할 수 있기 때문이다.

다음에 다운로드 코드를 점검한다면

이번 결과를 바탕으로 다음에는 다운로드 코드의 세 부분을 먼저 확인하려고 한다.

  • 입력: 엑셀을 만들기 전에 조회 결과 전체를 List에 담고 있지는 않은가?
  • 생성: SXSSF를 사용하면서도 처리한 입력 데이터를 다른 컬렉션에 계속 누적하고 있지는 않은가?
  • 출력: 마지막에 완성 파일 전체를 ByteArrayOutputStream이나 byte[]로 모으고 있지는 않은가?

한 요청이 성공하더라도 동시에 여러 다운로드가 실행되는 상황은 별도 검증이 필요하다. 이번 실험은 단일 요청에 해당하는 독립 프로세스에서 실행했으므로 동시 요청 처리 능력까지 확인한 것은 아니다.

당시 운영에서는 JVM 설정 조정과 SXSSF 전환 이후 재발이 없었다. 이번 실험은 그 결과의 원인을 소급해서 입증하는 것이 아니라, 비슷한 문제를 다시 만났을 때 어디를 확인할지 이해하기 위한 후속 학습이다.

LeetCode 1768. Merge Strings Alternately 풀이 복기

문제 이해

이번에 푼 문제는 Merge Strings Alternately이다.

문제 자체는 어렵지 않았다.
두 문자열이 주어지고, 첫 번째 문자열의 문자부터 시작해서 두 문자열의 문자를 번갈아가며 합치면 된다.

예를 들어 다음과 같은 입력이 있다고 하자.

word1 = "abc";
word2 = "pqr";

결과는 다음과 같다.

a p b q c r

그래서 최종 결과는 다음과 같다.

"apbqcr"

만약 두 문자열의 길이가 다르면, 짧은 문자열이 끝난 뒤에 긴 문자열의 남은 문자를 그대로 붙이면 된다.

예를 들어 다음과 같은 입력이 있다.

word1 = "ab";
word2 = "pqrs";

이면 a, p, b, q까지 번갈아 붙이고, word2에 남은 r, s를 뒤에 붙이면 된다.

결과는 다음과 같다.

"apbqrs"

알고리즘 분류

이 문제는 문자열 처리 문제이다.

두 문자열을 같은 인덱스 기준으로 번갈아 확인하면서 새로운 문자열을 만들어야 한다.
따라서 배열이나 문자열을 순서대로 순회하는 기본적인 문제에 가깝다.

세부적으로는 두 문자열을 각각 가리키는 인덱스를 사용한다는 점에서 투 포인터의 기초 형태로도 볼 수 있다.

다만 복잡한 포인터 이동 조건이 있는 문제는 아니고, 단순히 같은 인덱스 i를 기준으로 word1, word2를 차례대로 확인하는 문제이다.

사용한 자료구조는 결과 문자열을 만들기 위한 StringBuilder이다.

문제 유형: 문자열 처리
세부 주제: 문자열 병합, 인덱스 순회, 투 포인터 기초
난이도: Easy
자료구조: String, StringBuilder

처음 풀이

처음에는 두 문자열 중 더 긴 길이를 구한 다음, 그 길이만큼 반복문을 돌렸다.

class Solution {
    public String mergeAlternately(String word1, String word2) {
        String answer = "";

        int a = word1.length();
        int b = word2.length();
        int c = a > b ? a : b;

        for (int i = 0; i < c; i++) {
            if (a > i) {
                answer += word1.charAt(i);
            }

            if (b > i) {
                answer += word2.charAt(i);
            }
        }

        return answer;
    }
}

처음 생각은 단순했다.

두 문자열을 같은 인덱스 기준으로 하나씩 확인하면서, 해당 위치에 문자가 있으면 결과 문자열에 붙이면 된다고 생각했다.

그래서 word1.length()와 word2.length()를 각각 구하고, 둘 중 더 긴 길이만큼 반복문을 돌렸다.

int a = word1.length();
int b = word2.length();
int c = a > b ? a : b;

그리고 반복문 안에서는 현재 인덱스 i가 각 문자열의 길이보다 작은지 확인했다.

if (a > i) {
    answer += word1.charAt(i);
}

if (b > i) {
    answer += word2.charAt(i);
}

이렇게 하면 한쪽 문자열이 먼저 끝나도 에러가 나지 않고, 남아 있는 문자열의 문자만 계속 붙일 수 있다.

예를 들어 word1 = "ab", word2 = "pqrs"라면 흐름은 이렇게 된다.

i = 0
word1[0] = a 추가
word2[0] = p 추가

i = 1
word1[1] = b 추가
word2[1] = q 추가

i = 2
word1은 더 이상 문자가 없음
word2[2] = r 추가

i = 3
word1은 더 이상 문자가 없음
word2[3] = s 추가

결과적으로 "apbqrs"가 만들어진다.

풀이 로직 자체는 맞았고, 제출도 가능했다.

다만 다른 풀이를 보면서 Java에서 문자열을 반복해서 더할 때는 String +=보다 StringBuilder를 사용하는 게 더 좋다는 것을 다시 정리하게 됐다.


String +=가 아쉬운 이유

내 처음 풀이에서는 결과 문자열을 만들 때 이렇게 작성했다.

String answer = "";

answer += word1.charAt(i);
answer += word2.charAt(i);

처음 볼 때는 그냥 answer에 문자를 하나씩 붙이는 것처럼 보인다.

하지만 Java의 String은 불변 객체라서, 한 번 만들어진 문자열의 내용은 바뀌지 않는다.

그래서 +=로 문자열을 붙인다고 해서 기존 문자열 뒤에 바로 문자가 붙는 게 아니다.
실제로는 새로운 문자열이 계속 만들어진다.

예를 들어 이런 코드가 있다고 하자.

String answer = "";

answer += "a";
answer += "p";
answer += "b";
answer += "q";

내가 생각하기에는 answer 하나에 계속 문자가 붙는 느낌이지만, 실제로는 이런 식으로 동작한다.

처음 answer = ""

answer += "a"
→ 새로운 문자열 "a" 생성

answer += "p"
→ 새로운 문자열 "ap" 생성

answer += "b"
→ 새로운 문자열 "apb" 생성

answer += "q"
→ 새로운 문자열 "apbq" 생성

즉, 중간에 "a", "ap", "apb" 같은 문자열들이 계속 만들어진다.

물론 더 이상 사용하지 않는 문자열은 나중에 GC가 정리하겠지만, 반복문 안에서 이런 식으로 계속 문자열을 만들면 불필요한 객체 생성이 많아질 수 있다.

이번 문제는 문자열 길이가 최대 100이라서 사실 String +=로 풀어도 큰 문제는 없다.

하지만 Java에서 반복문으로 문자열을 조립해야 하는 상황이라면 StringBuilder를 쓰는 게 더 좋은 습관이라고 느꼈다.


StringBuilder로 개선한 풀이

그래서 StringBuilder를 사용하면 다음과 같이 작성할 수 있다.

class Solution {
    public String mergeAlternately(String word1, String word2) {
        StringBuilder answer = new StringBuilder();

        int a = word1.length();
        int b = word2.length();
        int c = Math.max(a, b);

        for (int i = 0; i < c; i++) {
            if (i < a) {
                answer.append(word1.charAt(i));
            }

            if (i < b) {
                answer.append(word2.charAt(i));
            }
        }

        return answer.toString();
    }
}

기존 풀이와 전체 흐름은 거의 같다.

달라진 부분은 결과 문자열을 만드는 방식이다.

기존에는 String을 사용했다.

String answer = "";
answer += word1.charAt(i);

개선 풀이에서는 StringBuilder를 사용했다.

StringBuilder answer = new StringBuilder();
answer.append(word1.charAt(i));

StringBuilder는 String처럼 매번 새로운 문자열을 만드는 방식이 아니라, 내부에 문자를 계속 추가하는 방식이다.

그래서 반복문 안에서 문자열을 조립할 때 더 적합하다.

마지막에는 StringBuilder를 그대로 반환할 수 없기 때문에 toString()으로 문자열로 변환해서 반환한다.

return answer.toString();

그리고 두 문자열 중 더 긴 길이를 구하는 부분도 삼항 연산자 대신 Math.max()를 사용했다.

int c = Math.max(a, b);

기존 코드의 아래 코드와 같은 의미다.

int c = a > b ? a : b;

다만 Math.max()가 더 큰 값을 구한다는 의도가 더 잘 보이는 것 같다.


시간복잡도

이 문제는 결국 두 문자열의 문자를 한 번씩 확인한다.

문자열 word1의 길이를 n, word2의 길이를 m이라고 하면 시간복잡도는 다음과 같다.

O(n + m)

반복문은 두 문자열 중 더 긴 길이만큼 돌지만, 실제로 결과 문자열에 추가되는 문자의 총 개수는 n + m개이다.

결국 두 문자열의 모든 문자를 한 번씩 처리하므로 O(n + m)으로 볼 수 있다.


공간복잡도

결과 문자열을 저장하기 위해 StringBuilder를 사용한다.

최종 결과 문자열의 길이는 word1.length() + word2.length()이다.

따라서 공간복잡도는 다음과 같다.

O(n + m)

입력 문자열을 제외하고, 결과를 만들기 위한 추가 공간이 필요하기 때문이다.


정리

이번 문제는 알고리즘 자체보다는 Java에서 문자열을 다루는 방식에 대해 다시 생각해볼 수 있는 문제였다.

처음 풀이처럼 String +=를 사용해도 문제는 풀린다.
특히 입력 크기가 작으면 성능 차이가 크게 느껴지지 않을 수도 있다.

하지만 Java의 String은 불변 객체이기 때문에 반복문 안에서 +=를 사용하면 새로운 문자열 객체가 계속 생성될 수 있다.

그래서 반복적으로 문자열을 만들어야 하는 경우에는 StringBuilder를 사용하는 것이 더 적절하다.

이번 문제를 풀면서 기억할 점은 다음과 같다.

1. 문자열을 번갈아 합칠 때는 같은 인덱스를 기준으로 접근하면 된다.
2. 한쪽 문자열이 먼저 끝날 수 있으므로 인덱스 범위 체크가 필요하다.
3. Java의 String은 불변 객체다.
4. 반복문에서 문자열을 계속 붙일 때는 StringBuilder를 사용하는 것이 좋다.
5. StringBuilder로 만든 결과는 마지막에 toString()으로 변환해서 반환한다.

처음에는 단순히 문제를 맞히는 데 집중했는데, 풀이를 다시 보면서 String +=와 StringBuilder의 차이를 정리할 수 있었다.

앞으로 반복문 안에서 문자열을 조립해야 하는 문제가 나오면 StringBuilder를 먼저 떠올려야겠다.

static boolean isPrime(int num) {
    if (num < 2) return false;

    for (int i = 2; i * i <= num; i++) {
        if (num % i == 0) return false;
    }
    return true;
}


백준 2581번 풀다가 정리

1. 구글 클라우드 로그인

https://cloud.google.com/free?utm_source=google&utm_medium=cpc&utm_campaign=japac-KR-all-ko-dr-BKWS-all-core-trial-EXA-dr-1710102&utm_content=text-ad-none-none-DEV_c-CRE_668690472449-ADGP_Hybrid+%7C+BKWS+-+EXA+%7C+Txt+-GCP-General-core+brand-main-KWID_43700077514871055-kwd-6458750523&userloc_1009853-network_g&utm_term=KW_google+cloud&gad_source=1&gclid=Cj0KCQjw2ZfABhDBARIsAHFTxGx1L77xMGjYqC88XUk3PlxCYMPheRU28eD0s56u0E9txjBmV5vXrSoaAq02EALw_wcB&gclsrc=aw.ds


https://cloud.google.com/free?gad_source=1&gclid=Cj0KCQjw2ZfABhDBARIsAHFTxGx1L77xMGjYqC88XUk3PlxCYMPheRU28eD0s56u0E9txjBmV5vXrSoaAq02EALw_wcB&gclsrc=aw.ds&userloc_1009853-network_g=&utm_campaign=japac-KR-all-ko-dr-BKWS-all-core-trial-EXA-dr-1710102&utm_content=text-ad-none-none-DEV_c-CRE_668690472449-ADGP_Hybrid+%7C+BKWS+-+EXA+%7C+Txt+-GCP-General-core+brand-main-KWID_43700077514871055-kwd-6458750523&utm_medium=cpc&utm_source=google&utm_term=KW_google+cloud


cloud.google.com


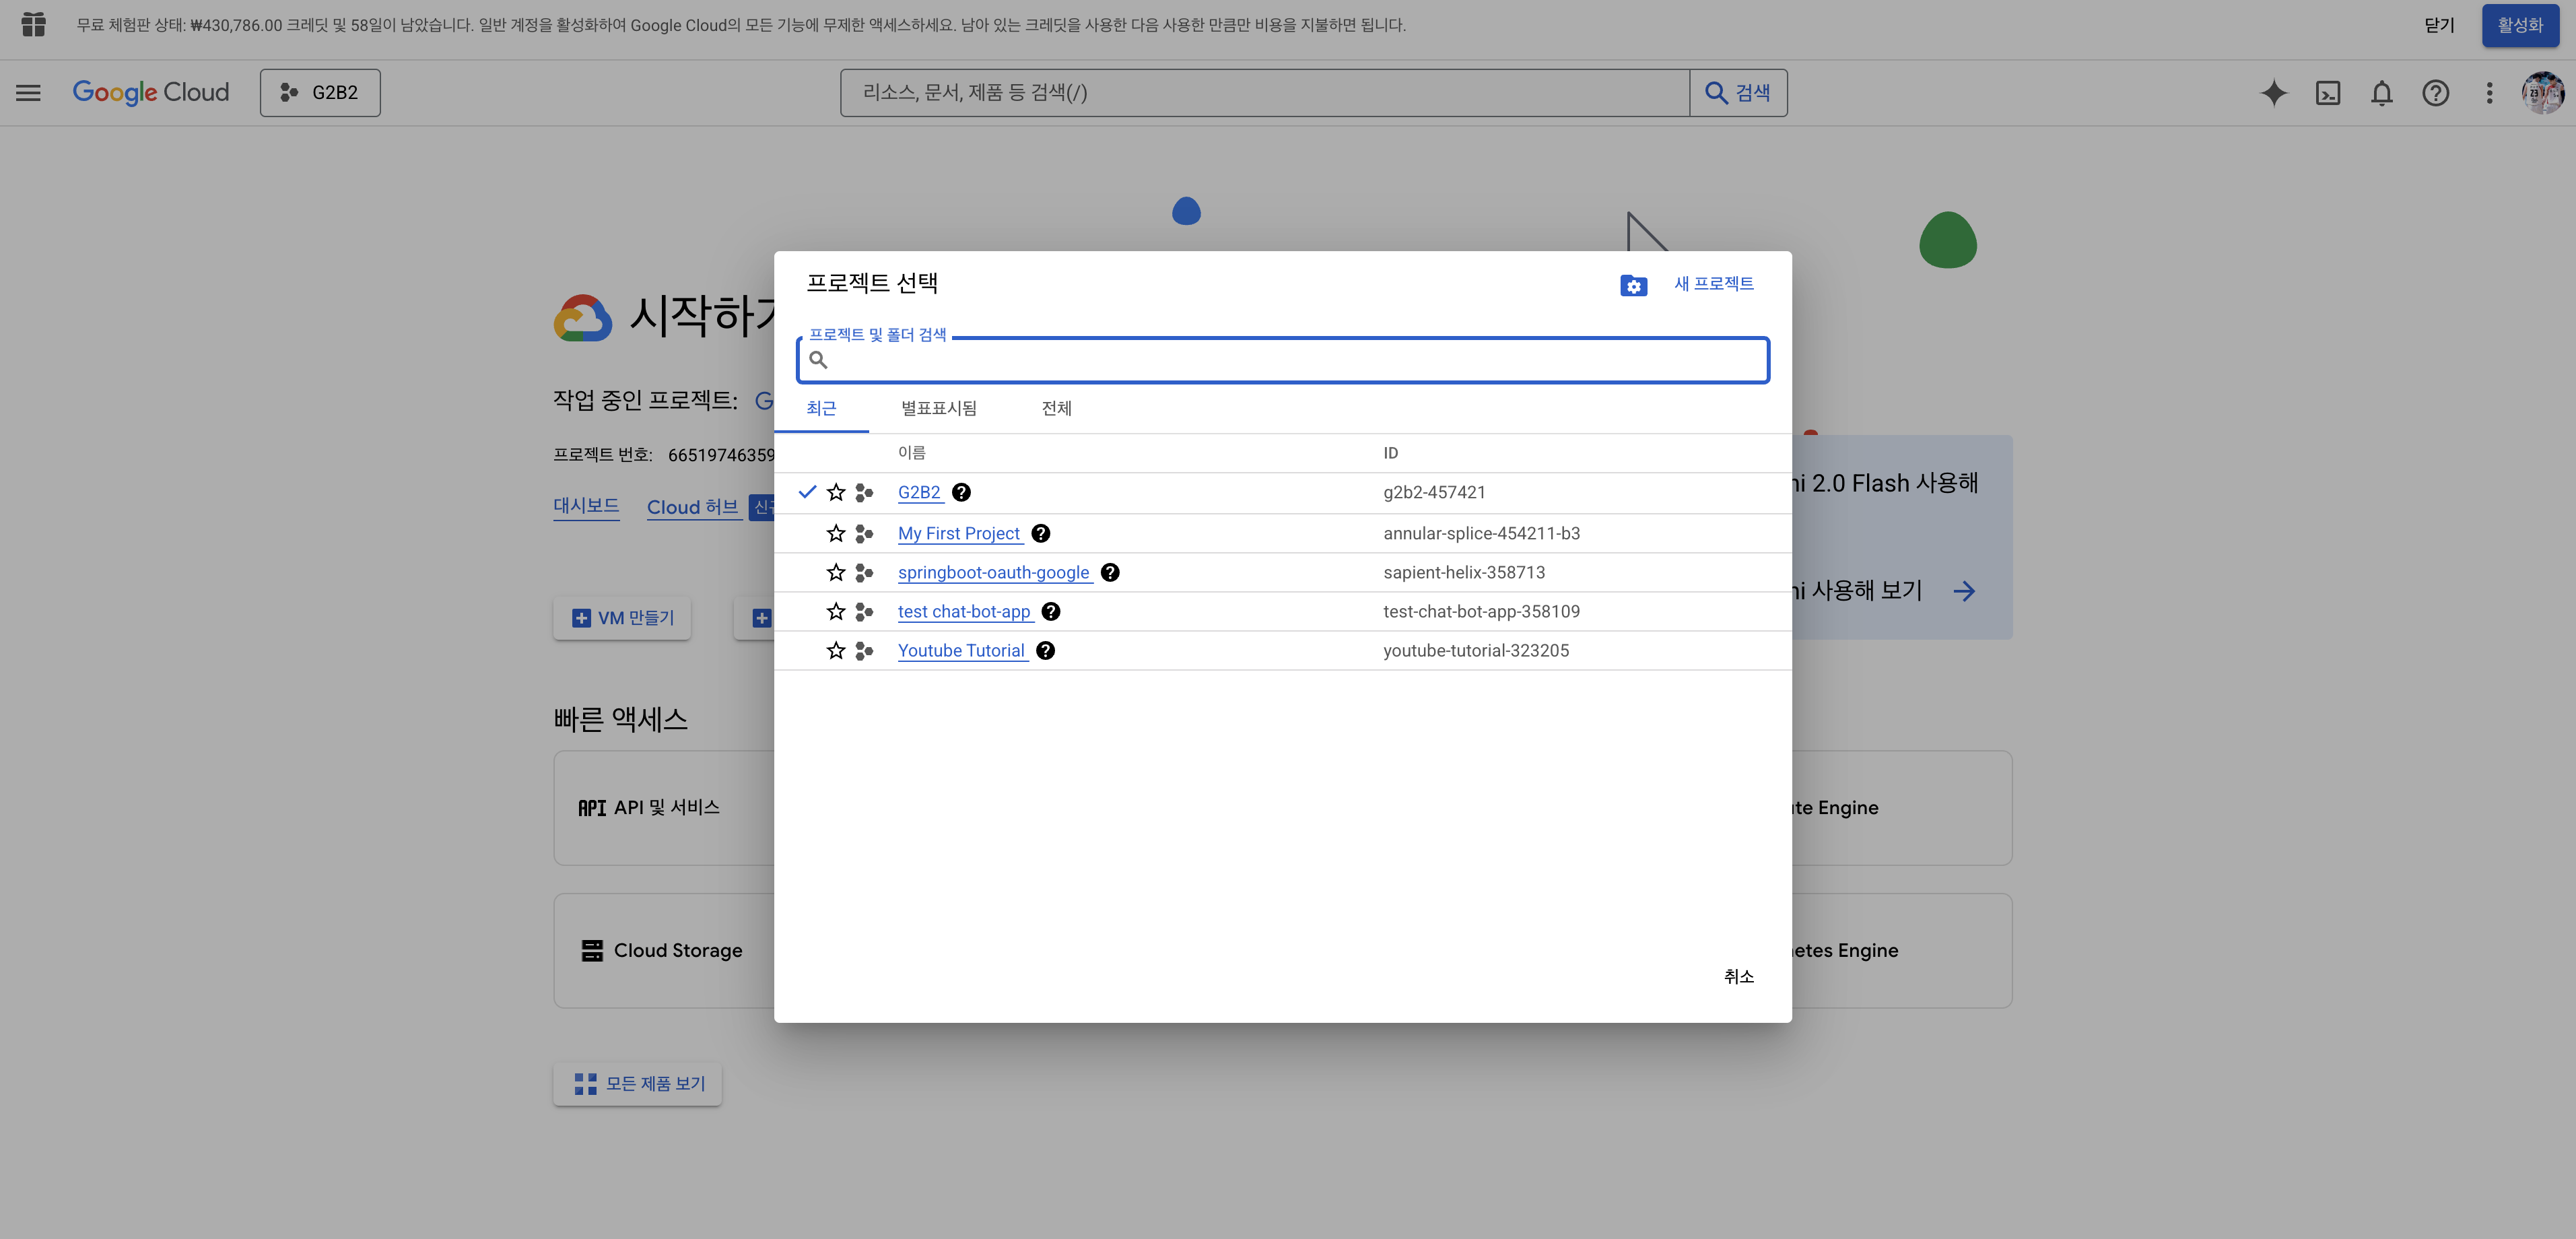
2. 새 프로젝트 만들기


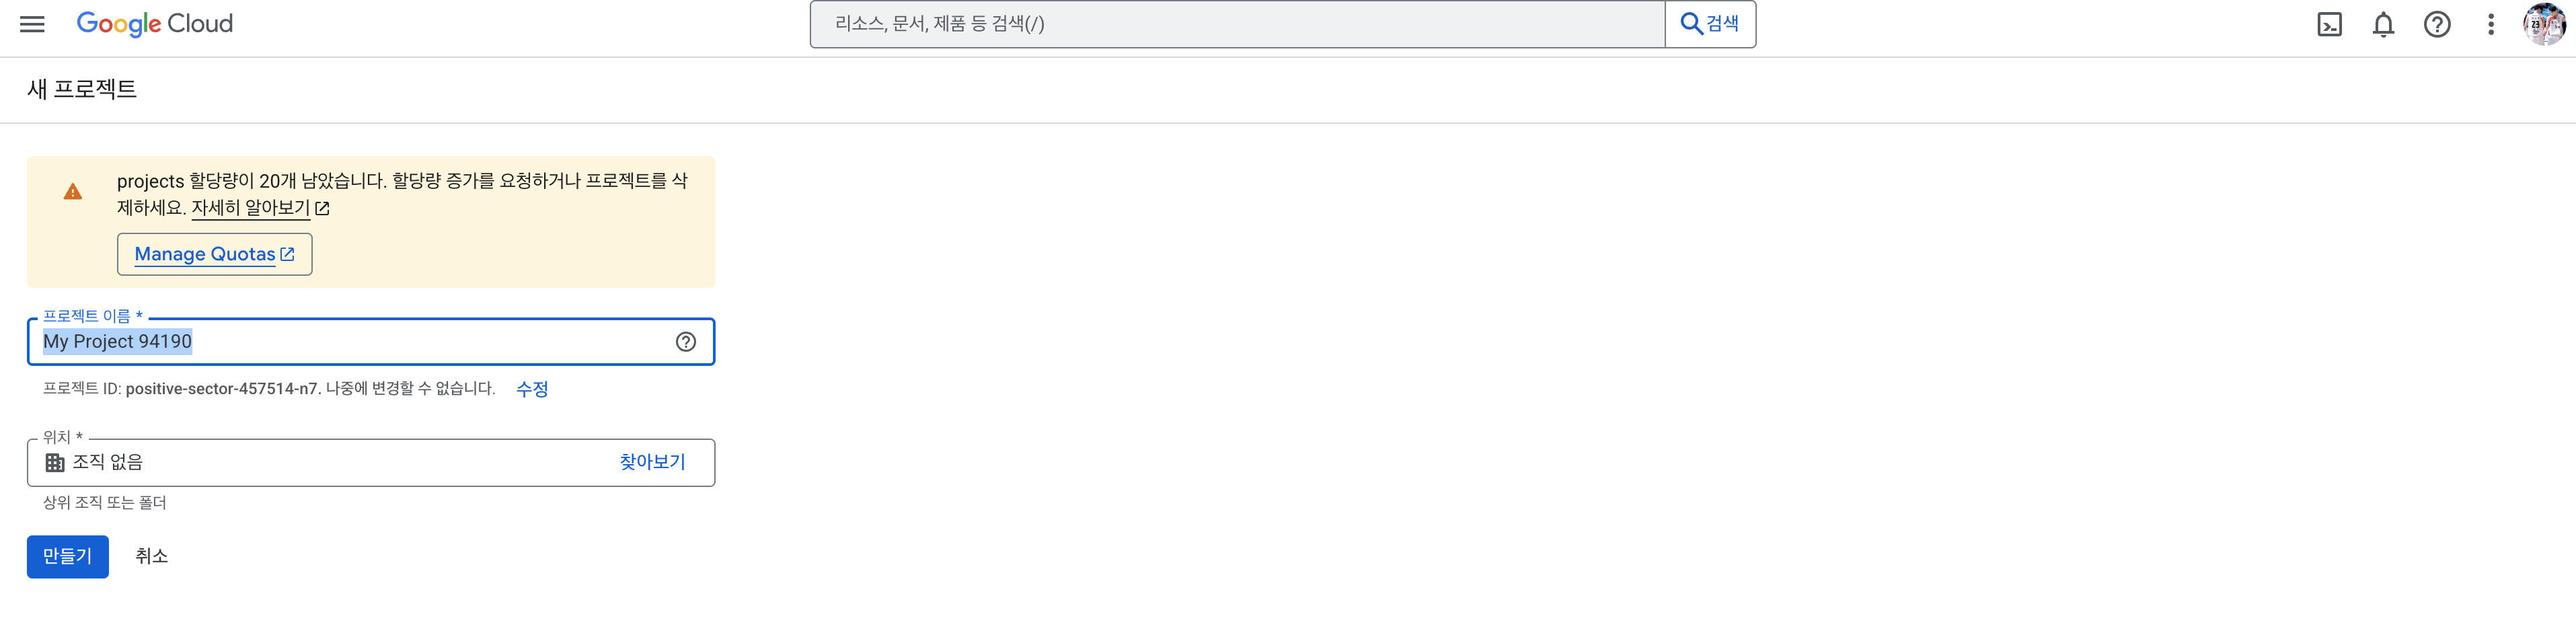
프로젝트 이름 자유롭게 작성하시고 위치는 작성안해도 됩니다.

만들기 버튼 클릭


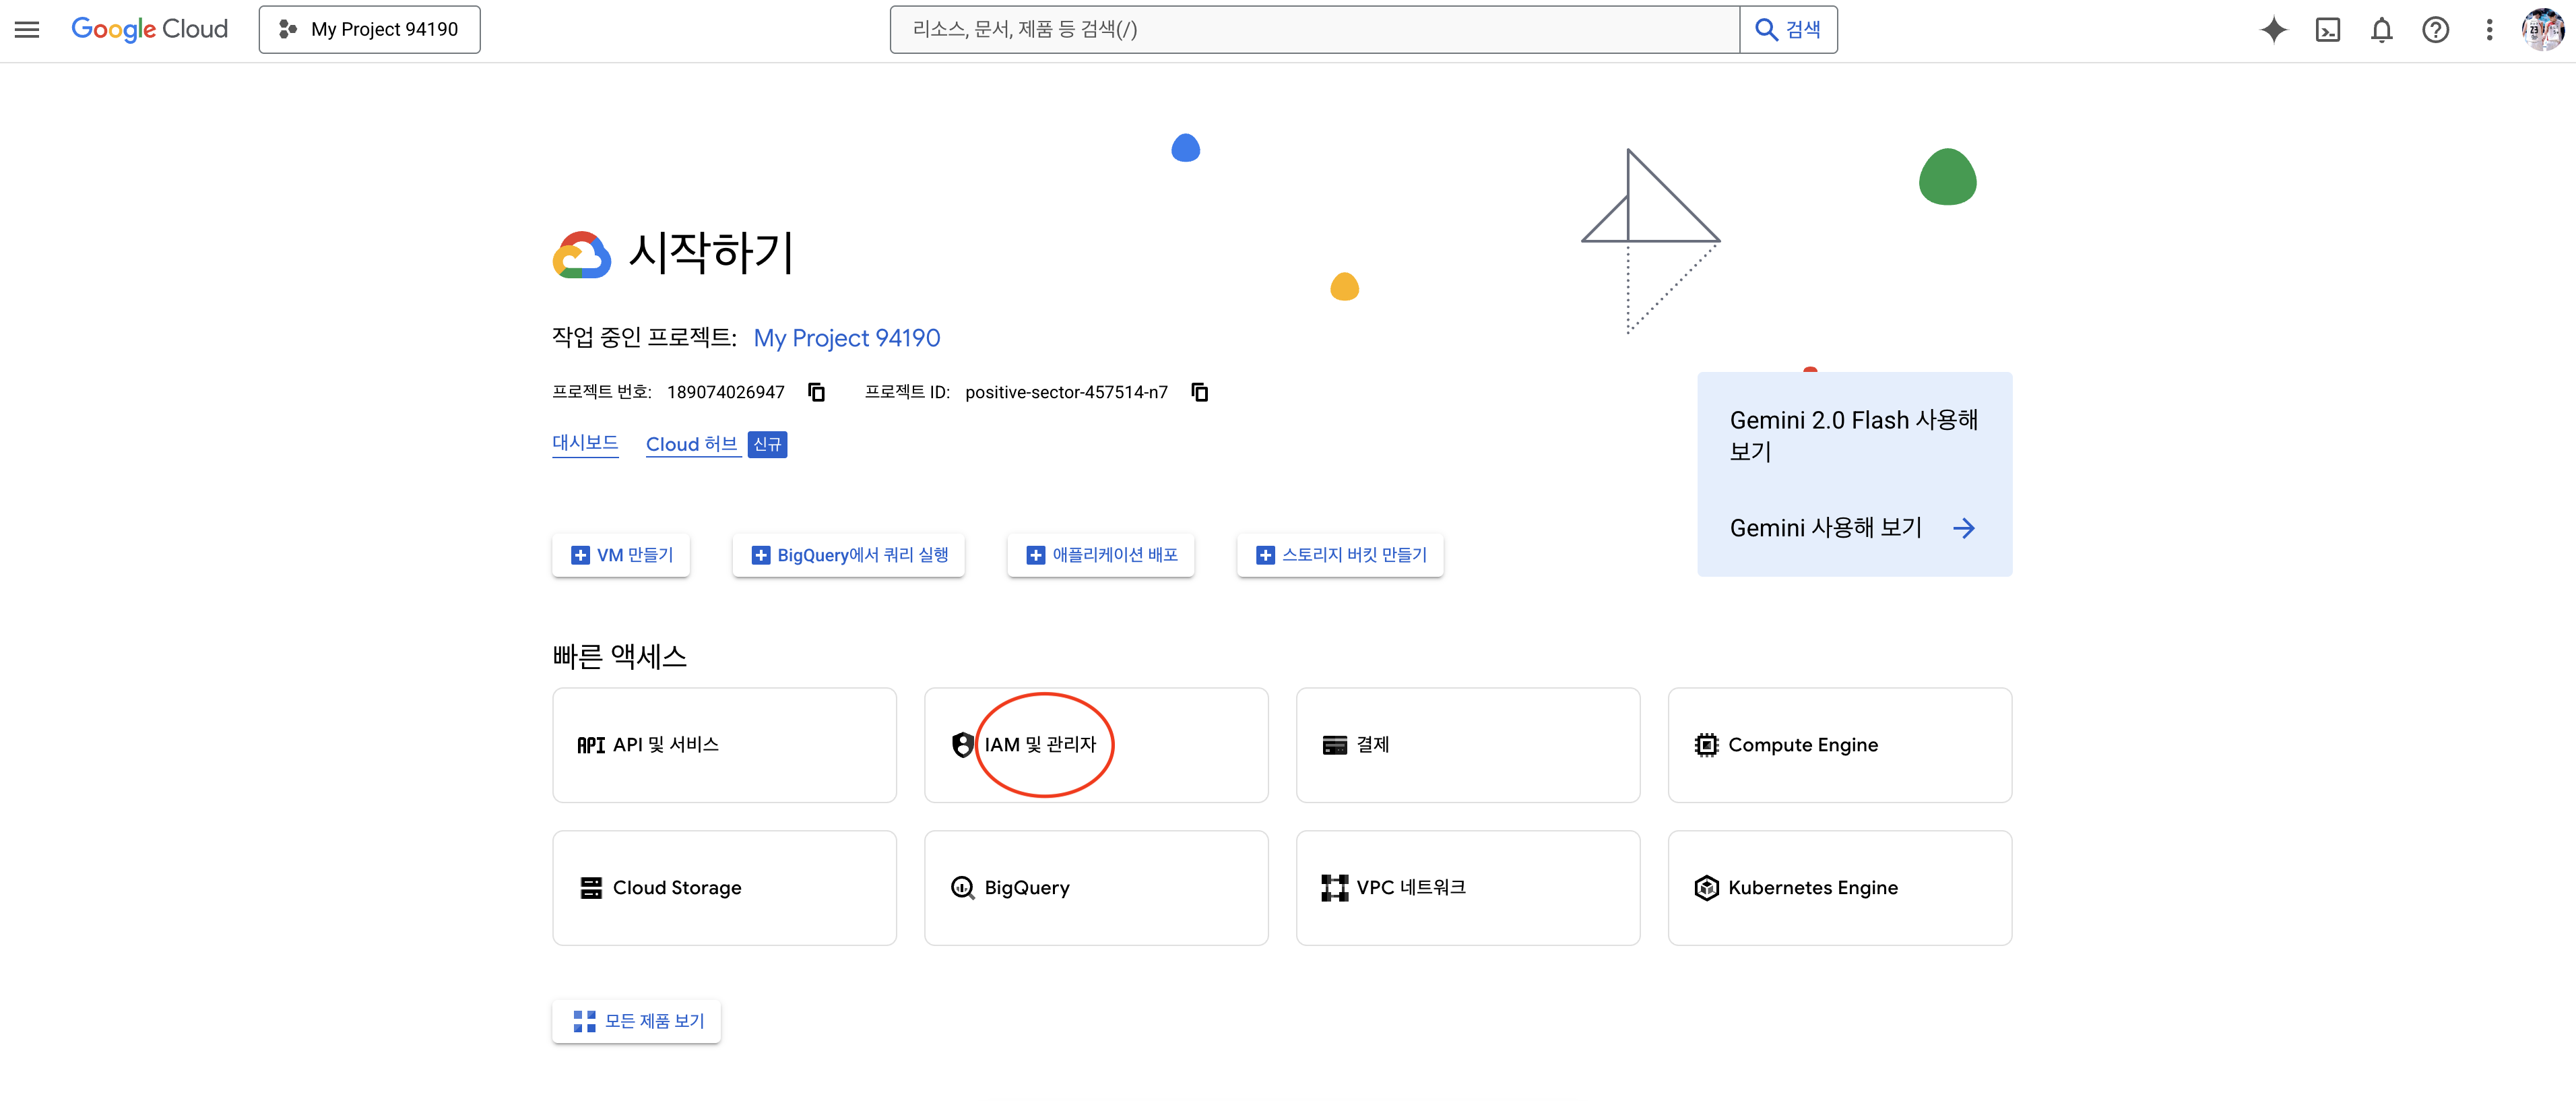
3. Google Sheets API 활성화

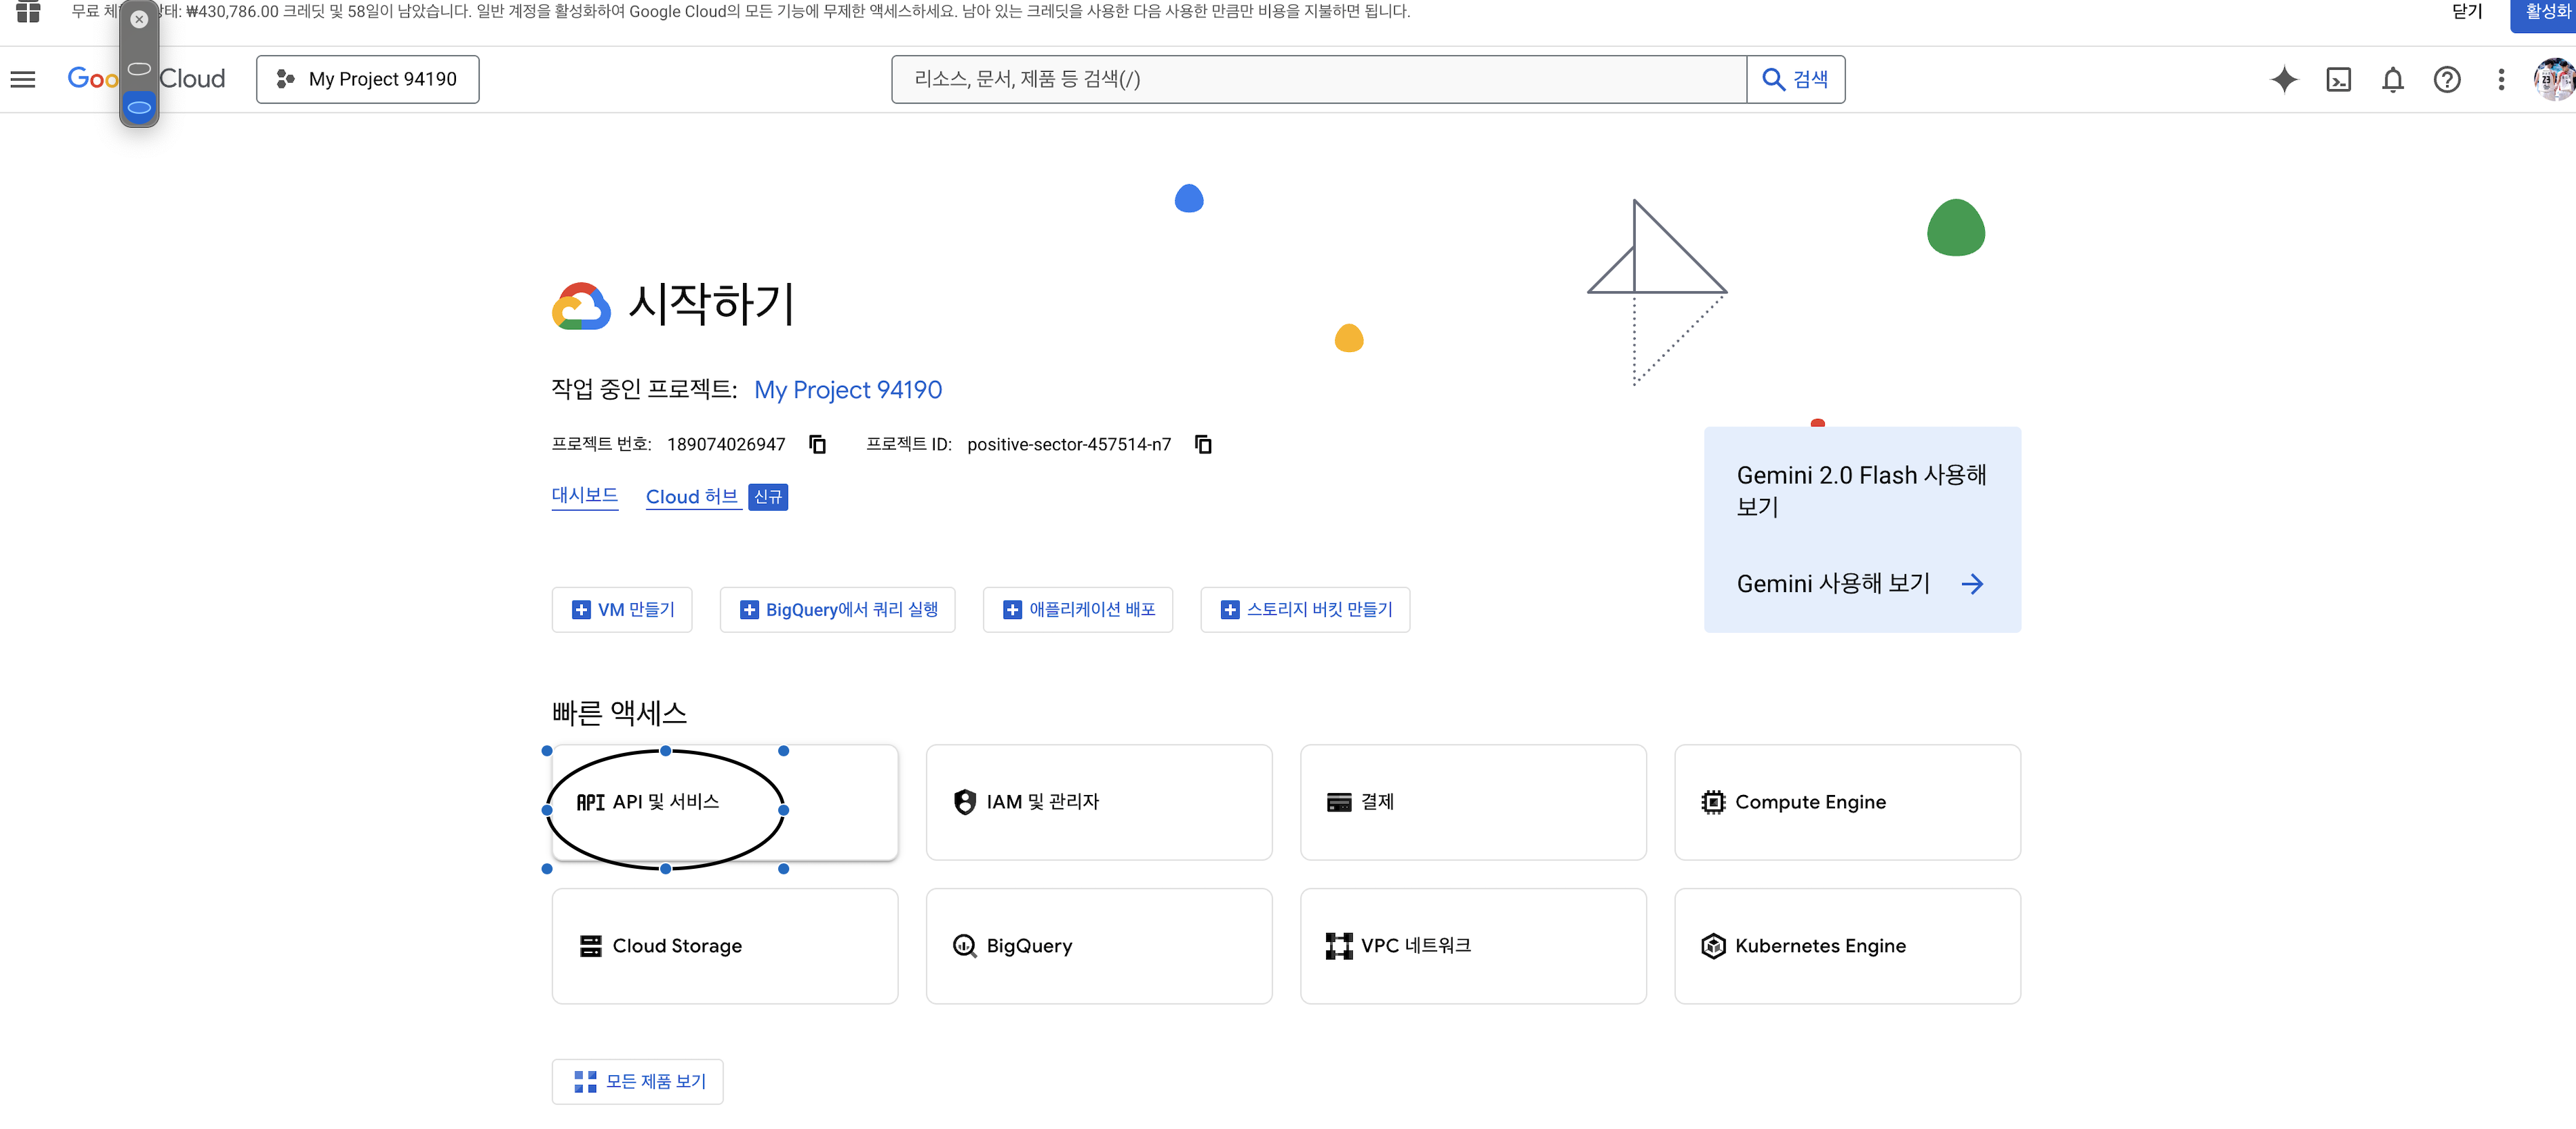
API 및 서비스 클릭


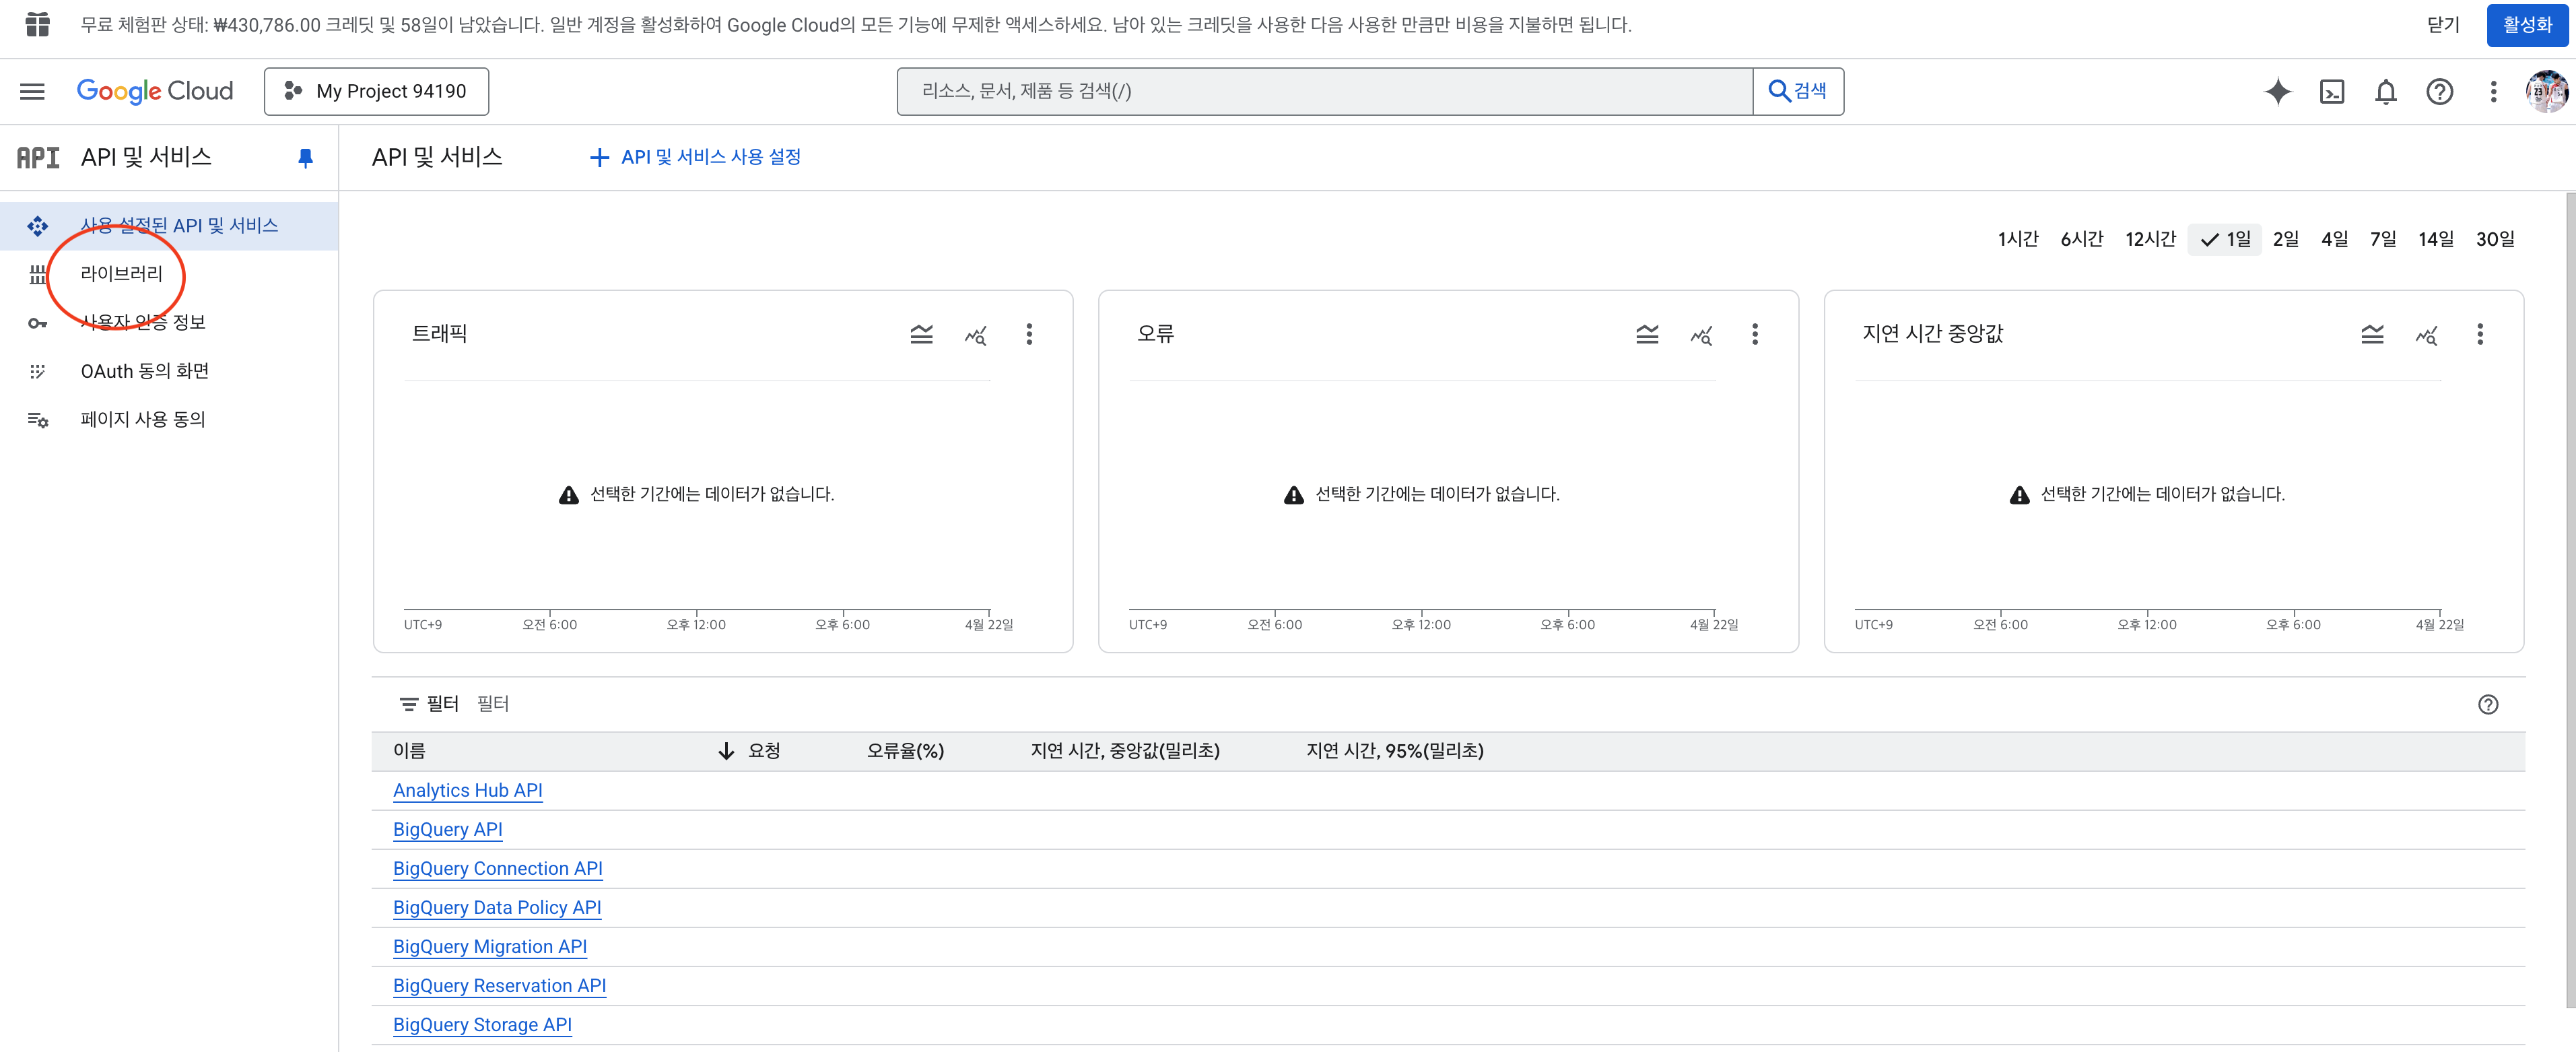
라이브러리 클릭


Google Sheets API 검색해서 사용 클릭


4. 서비스 계정 생성 및 키 발급

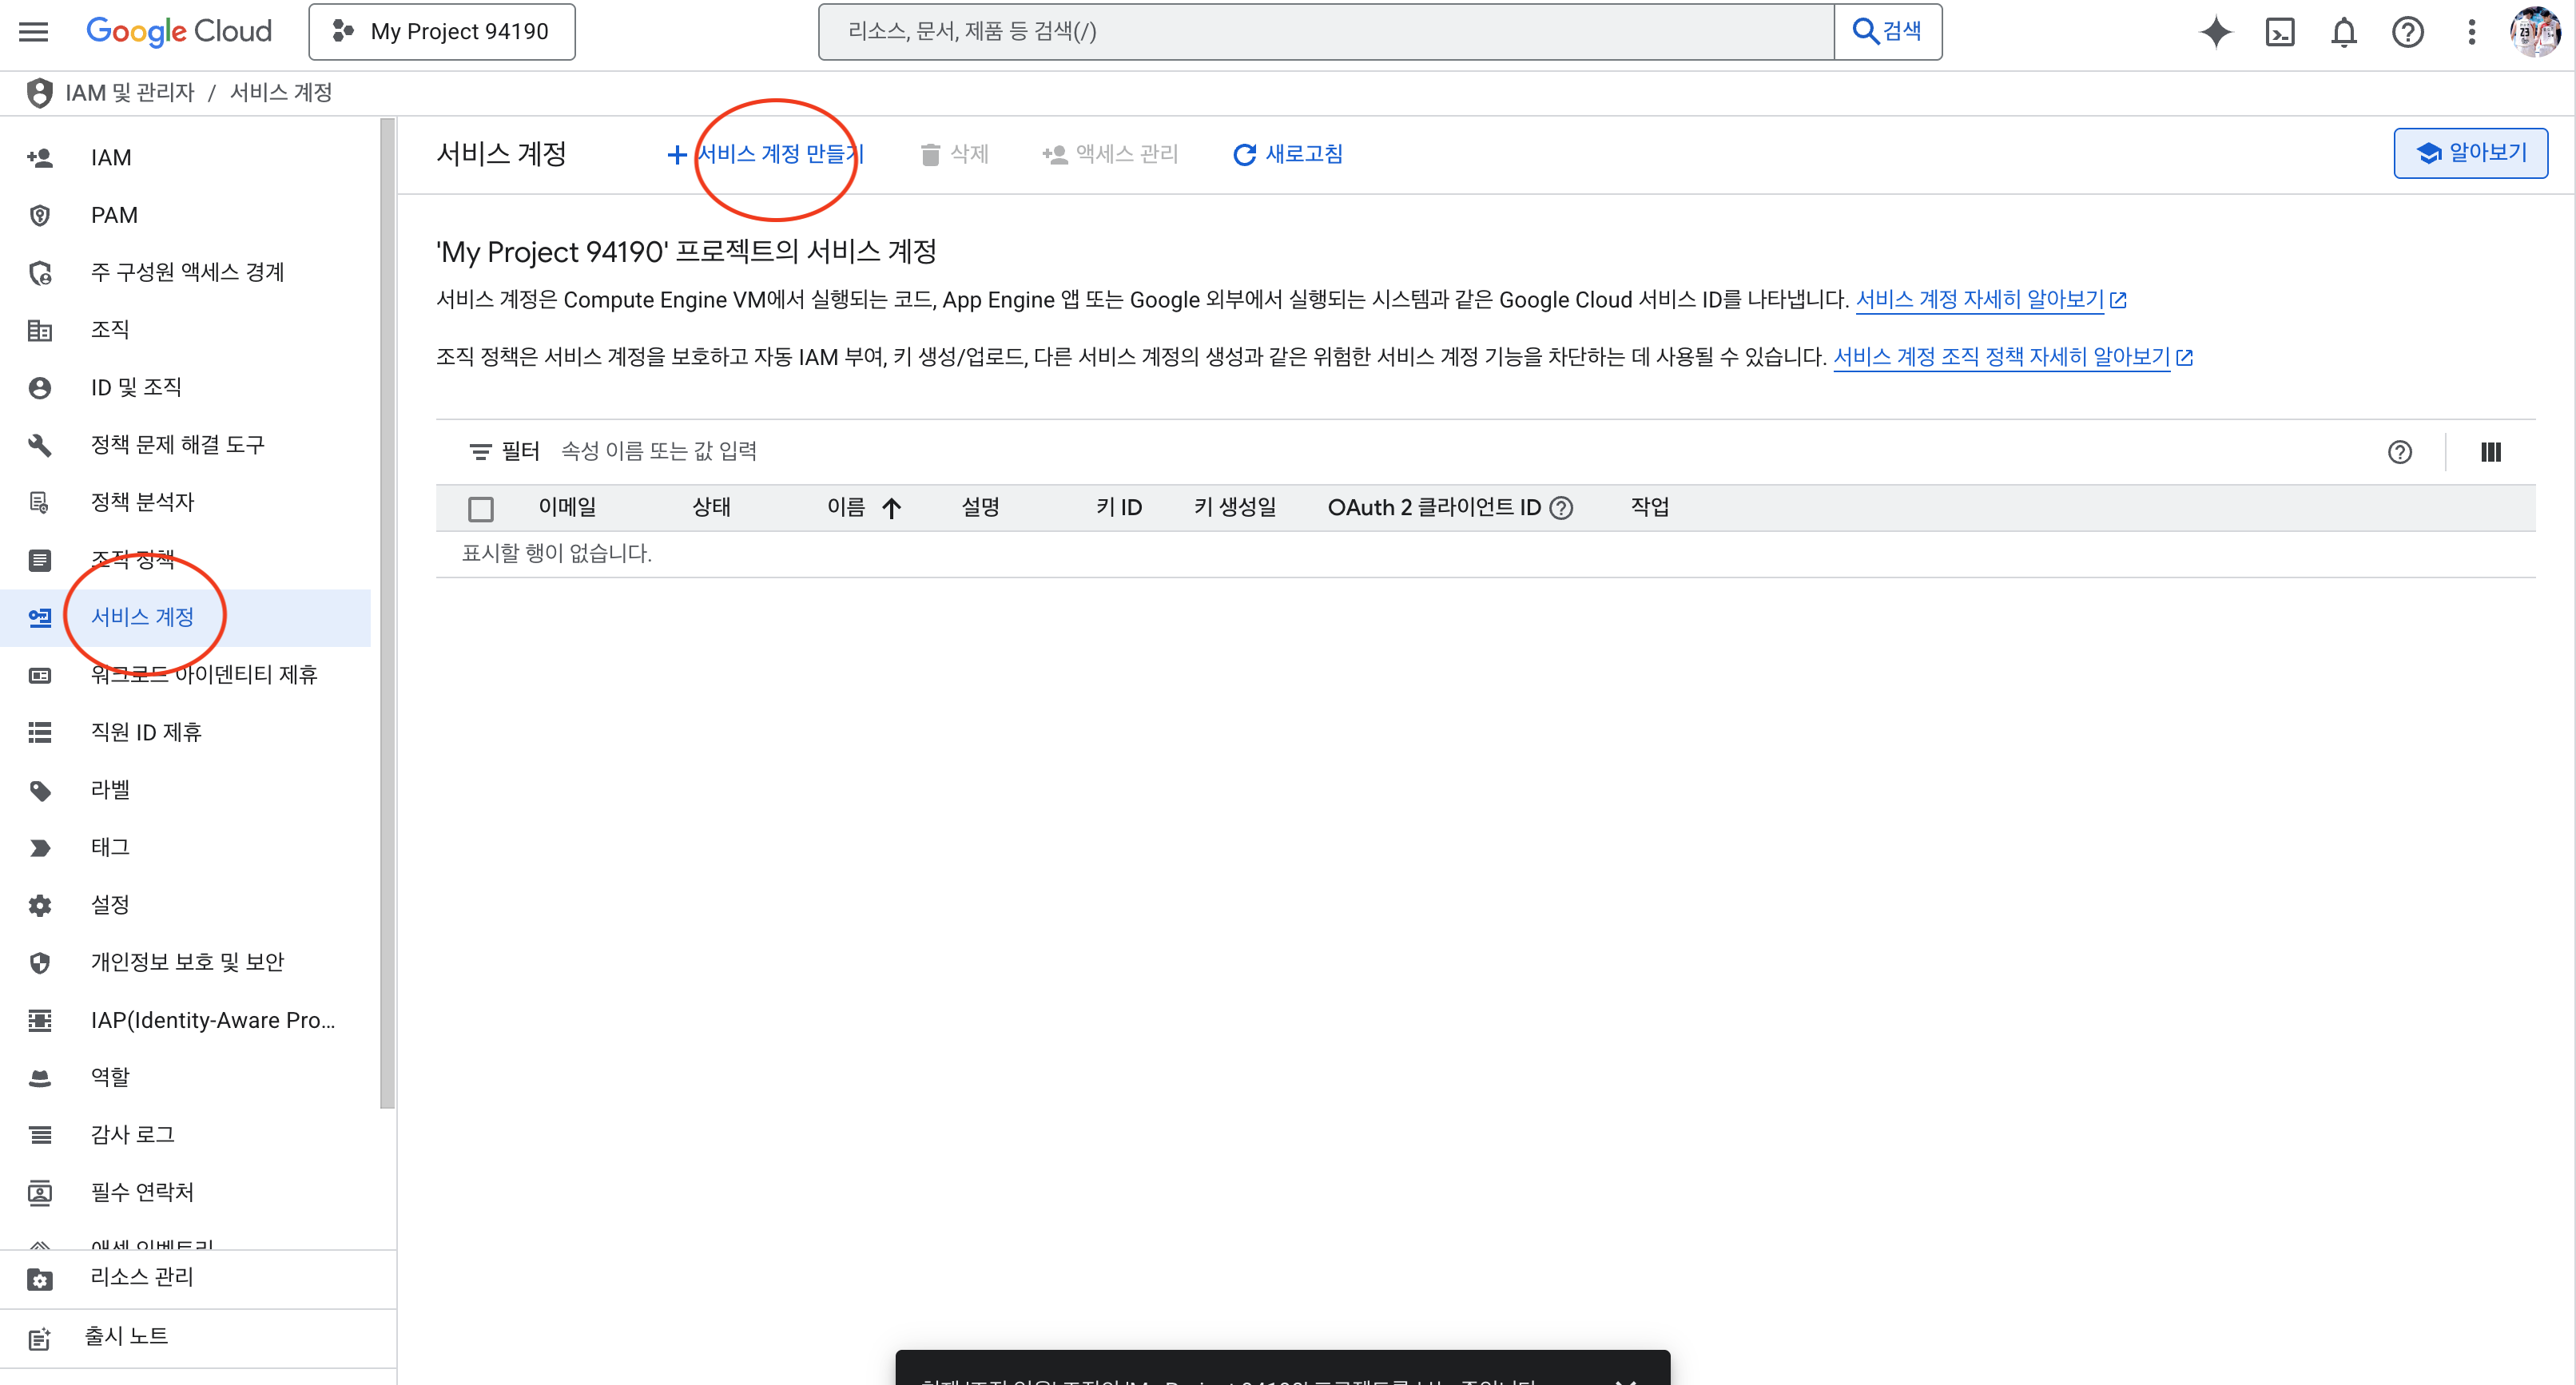
IAM 및 관리자 클릭


서비스계정 -> 서비스 계정 만들기 클릭


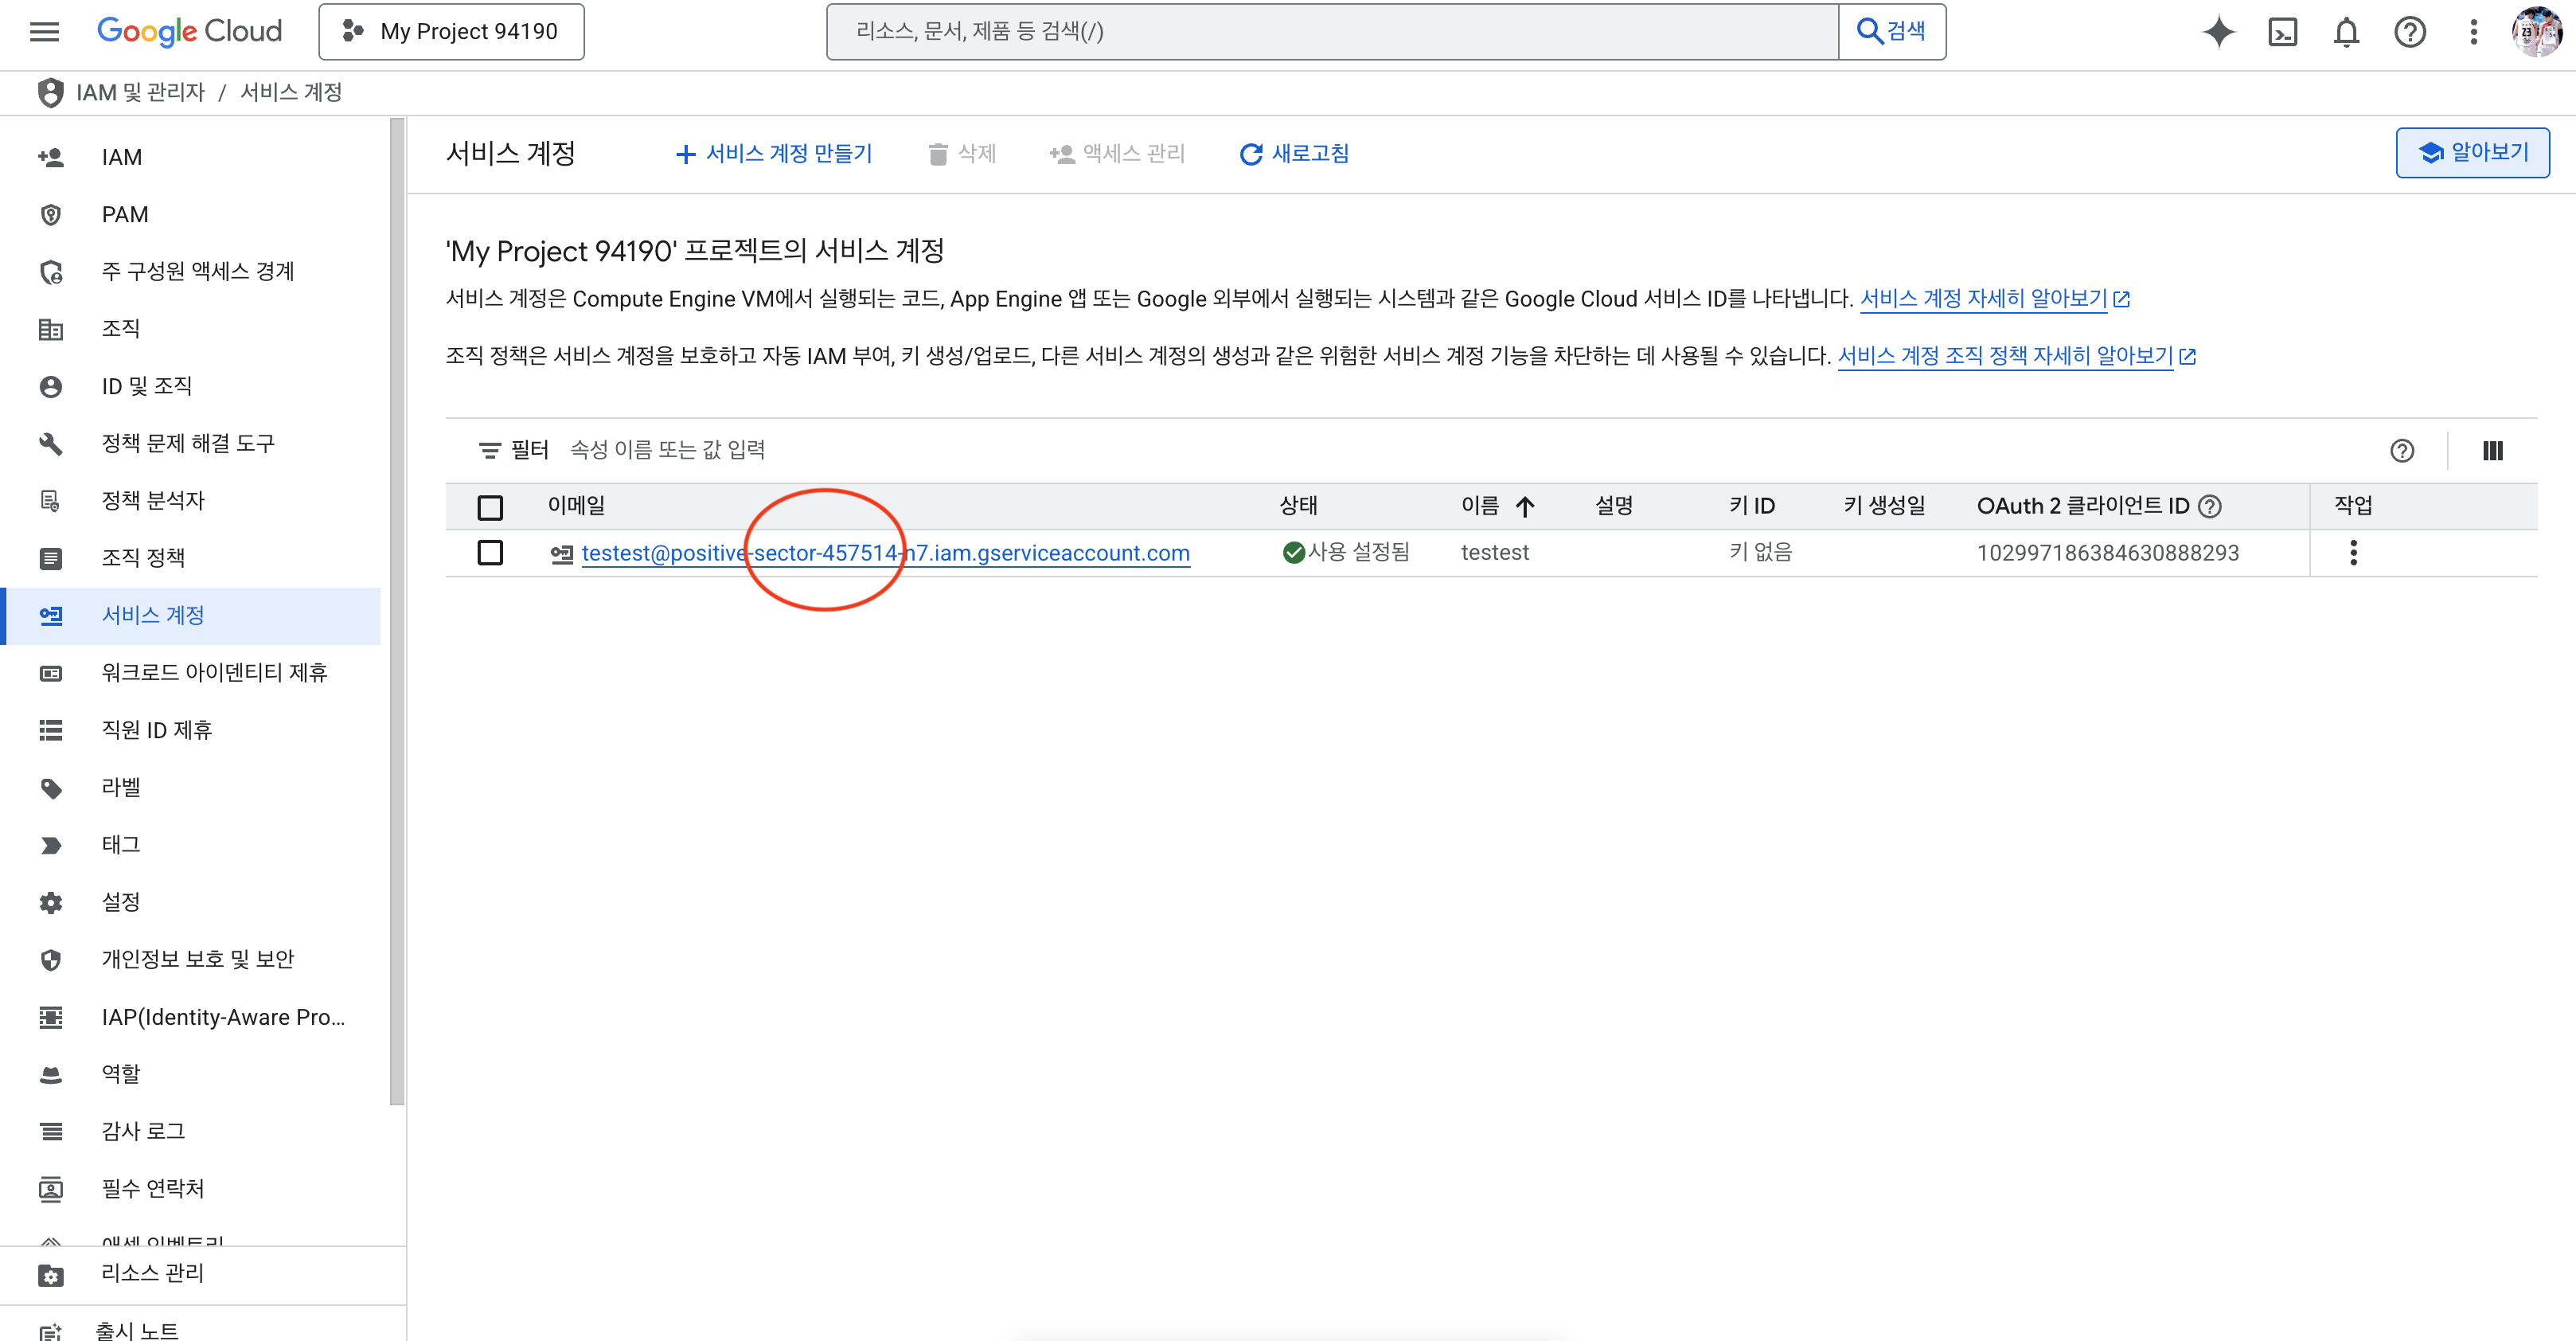
서비스 계정 이름 작성 후 완료 클릭


생성된 이메일 클릭

이 이메일 주소 저장해두기


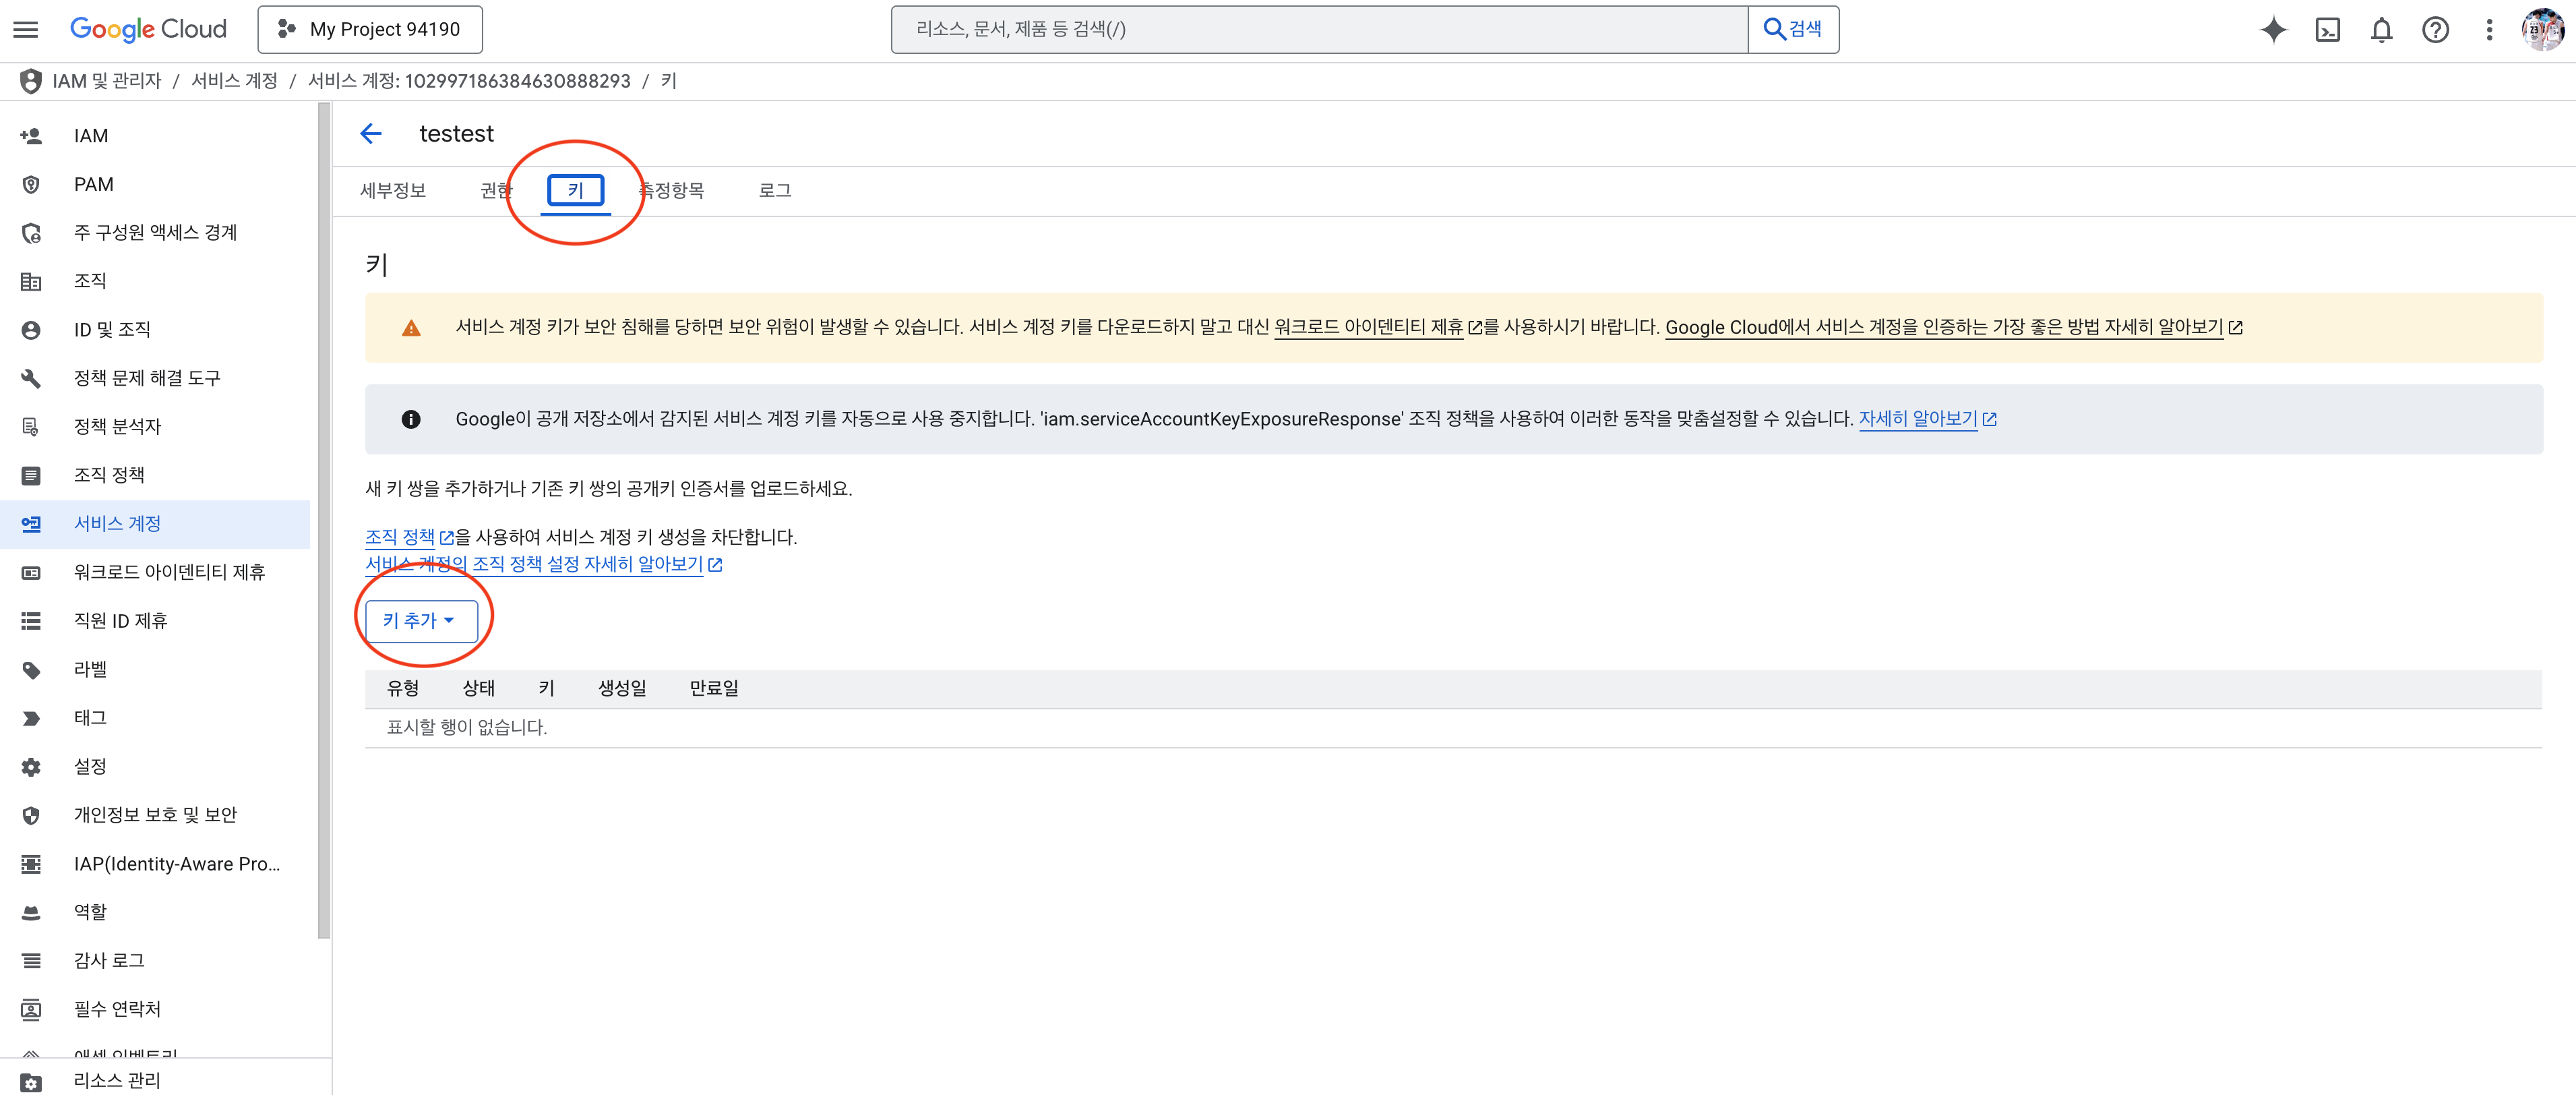
키 -> 키 추가 -> 새키만들기 클릭


JSON 선택 후 만들기 클릭


만들기 클릭시 다운로드 된 JSON파일 저장해두기


5. Google Sheets 생성

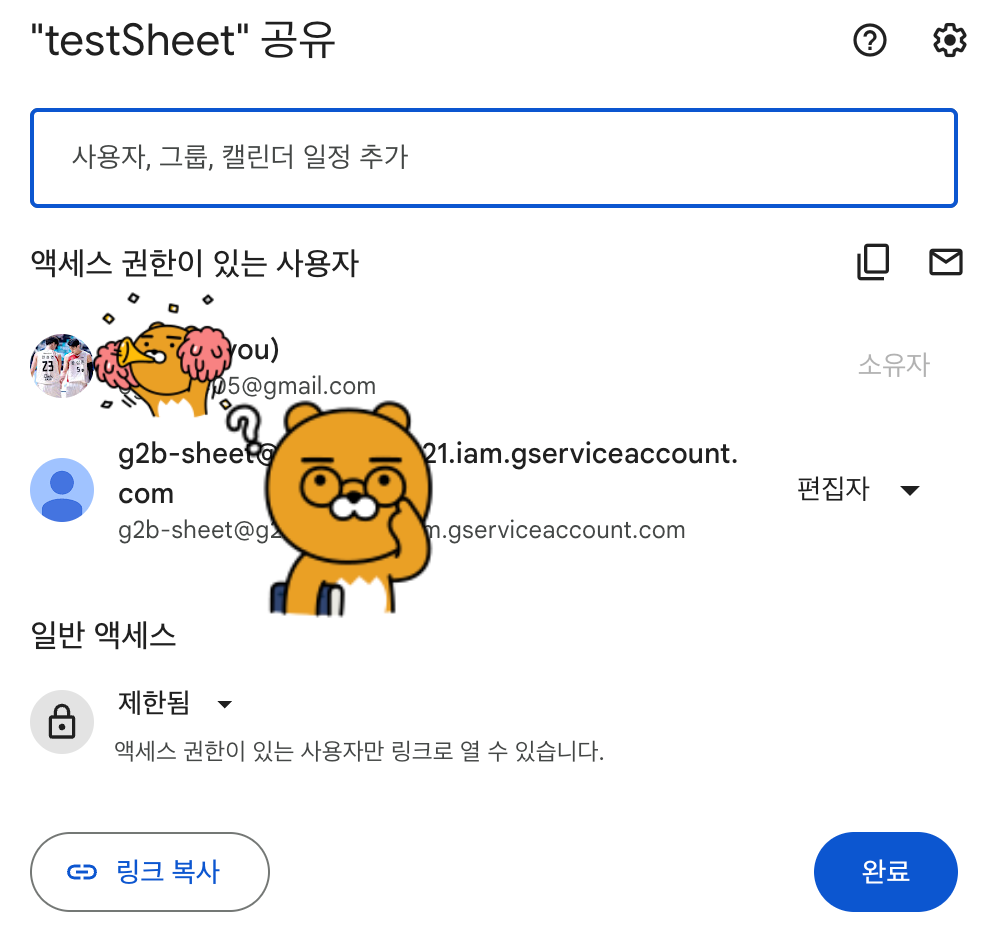
공유버튼 클릭 해서 아까 저장해둔 이메일 주소를 편집자로 선택해서 공유하기


이 시트 정보와 저장한 JSON 키값으로 프로젝트와 구글스프레드시트 연동 진행함.

프로젝트 진행 중에 공공기관 API를 통해서 대용량으로 데이터를 받을 일이 생겼다. 안써본 JPA를 써보겠다고 무작정 JPA로 코드를 작성하였다. 데이터를 받는데 너무 오랜 시간이 걸려서 어떻게 하면 좀 더 빠르게 다운로드가 가능할지 고민해보았다. 여러가지로 조사해본 결과, 대용량 데이터 처리에는 MyBatis가 적합하다는 결론을 얻어 정리해보았다.


대용량 데이터 처리 시 JPA vs MyBatis 성능 비교

JPA와 MyBatis는 각각의 장점이 있지만, 대량 데이터를 처리할 때는 일반적으로 MyBatis가 더 빠릅니다.
그 이유와 상황별 최적의 선택을 정리해 보겠습니다.


1. JPA와 MyBatis의 차이점

특징 JPA (Hibernate) MyBatis

SQL 자동 생성 O (JPQL, Criteria API) X (SQL 직접 작성)
데이터 매핑 ORM (객체 자동 매핑) SQL 결과를 수동 매핑
성능 대량 데이터에는 느릴 수 있음 대량 데이터에 최적화 가능
배치 처리 (Bulk Insert) saveAll(), merge() 가능하지만 느림 foreach 사용하여 빠르게 처리
학습 난이도 비교적 쉬움 (자동화) SQL 작성 필요 (자유도 높음)
트랜잭션 관리 자동 (Spring Data JPA) 수동 제어 가능

2. 대량 데이터 처리에서 MyBatis가 빠른 이유

- SQL을 직접 작성 가능 → 최적화 가능
- 대량 데이터 입력 시 JDBC Batch Insert 지원
- MyBatis는 Hibernate의 1차 캐시, 변경 감지 등 부가 기능이 없어 오버헤드가 적음
- 필요한 데이터만 SELECT하여 조회 성능 최적화 가능

JPA의 성능 저하 원인

  1. Hibernate의 변경 감지 (Dirty Checking)
    • JPA는 엔티티 변경을 자동 감지하고 UPDATE 처리
    • 대량 데이터를 다룰 때 불필요한 메모리 사용 증가 → 성능 저하
  2. 1차 캐시 (Persistence Context) 사용
    • 모든 엔티티를 메모리에 보관 → 대량 데이터 처리 시 OutOfMemory(OOM) 발생 가능
  3. Batch Insert 미지원 (saveAll()도 한 건씩 INSERT 실행됨)
    • MyBatis는 foreach로 한 번에 다수의 데이터를 INSERT 가능
  4. JPQL의 제한
    • 복잡한 SQL 최적화가 어려움 → JOIN 최적화 등 MyBatis보다 불리

3. 대량 데이터 처리 시 성능 최적화 방법

(1) JPA에서 Batch Insert 적용 (성능 개선)

@PersistenceContext
private EntityManager entityManager;

@Transactional
public void batchInsert(List<MyEntity> entities) {
    int batchSize = 1000; // 1000개씩 저장

    for (int i = 0; i < entities.size(); i++) {
        entityManager.persist(entities.get(i));

        if (i % batchSize == 0) {
            entityManager.flush();
            entityManager.clear();
        }
    }
}

개선 효과:

  • flush()와 clear()를 사용하여 메모리 누수 방지
  • 배치 크기(batchSize)를 조절하여 성능 최적화

(2) MyBatis를 활용한 Batch Insert

<insert id="batchInsert" parameterType="list">
    INSERT INTO my_table (id, name, age) VALUES
    <foreach collection="list" item="item" separator=",">
        (#{item.id}, #{item.name}, #{item.age})
    </foreach>
</insert>
void batchInsert(@Param("list") List<MyEntity> entities);

MyBatis에서는 foreach 문을 사용하여 한 번에 다수의 데이터를 INSERT 가능!

JDBC Batch 지원 → 성능 최적화
개별 SQL 실행보다 속도 빠름


(3) MyBatis에서 ON DUPLICATE KEY UPDATE 활용

<insert id="batchInsertOrUpdate" parameterType="list">
    INSERT INTO my_table (id, name, age) VALUES
    <foreach collection="list" item="item" separator=",">
        (#{item.id}, #{item.name}, #{item.age})
    </foreach>
    ON DUPLICATE KEY UPDATE 
    name = VALUES(name),
    age = VALUES(age)
</insert>

MySQL에서 중복된 키가 있으면 UPDATE, 없으면 INSERT
JPA의 merge()보다 훨씬 빠름


4. 실제 성능 비교

방식 10,000건 INSERT 100,000건 INSERT 1,000,000건 INSERT

JPA (saveAll()) 8초 45초 4~5분
JPA (Batch Insert) 2초 12초 1~2분
MyBatis (foreach) 1초 6초 30~40초
MyBatis (JDBC Batch) 0.5초 3초 20~30초

대량 데이터 삽입 시 MyBatis가 JPA보다 2~5배 이상 빠름!


 결론: 언제 JPA vs MyBatis를 써야 할까?

사용 사례 JPA MyBatis

소량 데이터 (1~10만 건) ✅ ✅
대량 데이터 삽입 (10만~100만 건) ❌ ✅
복잡한 SQL 최적화 필요 ❌ ✅
엔티티 기반 개발 (비즈니스 로직 중요) ✅ ❌
JOIN, GROUP BY 최적화 필요 ❌ ✅
캐싱 및 자동 관리 필요 ✅ ❌

대량 데이터 처리라면 MyBatis를 추천!
JPA를 써야 한다면 Batch Insert 적용 필수!
트랜잭션 관리가 중요한 경우 JPA + Native Query 조합도 고려 가능


🔥 결론:

  • 대량 데이터(INSERT, UPDATE, DELETE가 많음) → MyBatis 추천
  • 비즈니스 로직 중심, 유지보수 중요 → JPA 사용 가능하지만 최적화 필수
  • JPA를 유지하면서 성능을 높이려면 batchInsert() 적용

1. git 설치

2. docker 설치

3. jdk 21 설치

4. build gradle(./gradlew clean build)

5. docker build -t g2bplatform:1.0 .

6. msyql설치

7. db 생성

8.  docker run -d -p 8080:8080 g2bplatform:1.0

9. 외부접속 설정하기

작업했던 내용들을 조금씩 정리하려고 한다.

관리하는 사이트의 SSL인증서를 갱신하라는 메일을 받았다.


안내해준 사이트로 들어가서 로그인 후 갱신하면 된다.


1. 갱신하기 위해서는 우선 결제를 해야한다.


스타(*) 인증서로 1년에 무려 484,000 원


그래도 결제 진행해주고, 결제 몇시간 후에 인증서 파일을 메일로 보내주었다.


보통 cert, key 이렇게 두개 파일이 들어있고, 방화벽용 파일을 따로 보내주는 곳도 있었다.

그럼 이제 이 파일들로 무엇을 해야하는가


2. pem 파일 안의 코드들을 가동중인 웹서버 NGINX로 옮기기

nginx를 접속해주자. 보통 SSL파일은 최상위 폴더에서 

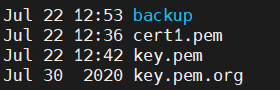
/etc/nginx/SSL 폴더 안에 존재한다.


기존 파일 백업을 잘해두자.(혹여나 그냥 바꿨는데 오류나면 낭패다.)

그리고 기존 파일명과 같게, 형식도 같게 해서 해당 폴더에 새 인증서 파일을 넣어준다.


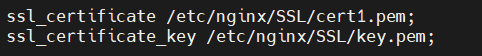
3. NGINX의 conf.d(설정) 확인

vi 명령어를 통해 conf.d파일을 열어서 설정을 확인한다.

폴더의 위치나 파일명이 맞는지 확인하면 된다.


4. nginx 재기동

sudo nginx -t

명령어로 별 문제 없는지 테스트 한번 해주고


이런 결과 나오면 nginx를 재기동해주면 된다.

sudo service nginx restart


5. 호스팅업체를 이용중인 경우 SSL인증서 파일 전달 후 적용 요청


이렇게 한 후 SSL인증서가 잘 적용되었는지 확인하면 된다.

인증서 확인 방법은 다음과 같다.


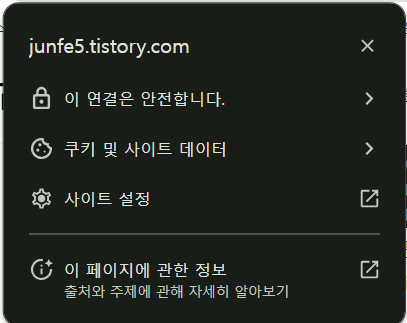
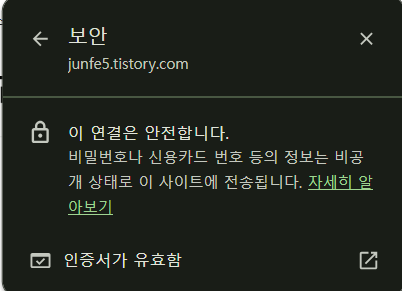
브라우저에서 url왼쪽에 아이콘 클릭


뜨는 창에서 '이 연결은 안전합니다.' 클릭


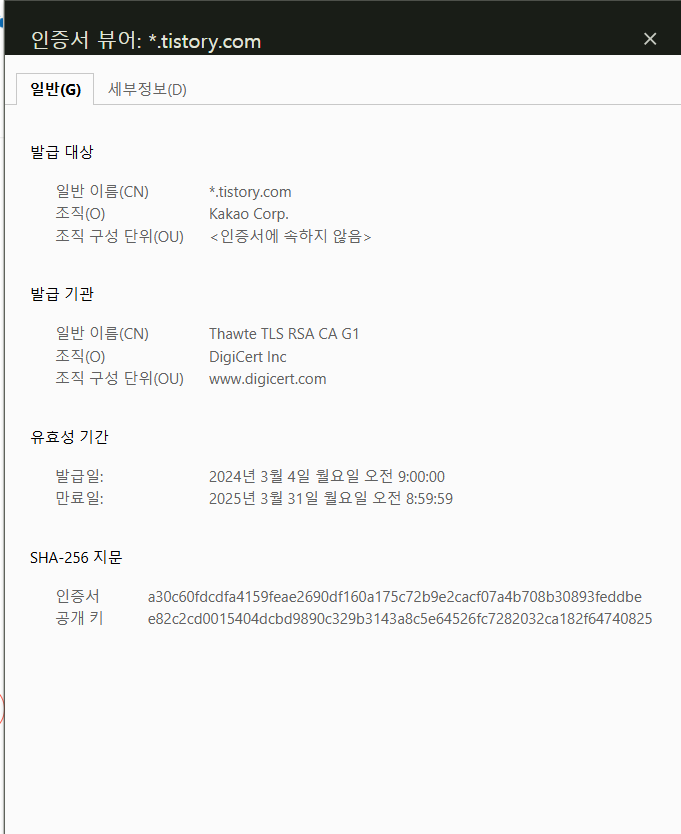
뜨는 창에서 '인증서가 유효함' 클릭


그럼 이렇게 인증서 정보와 만료일이 나온다.


여기서 인증서 만료일이 옳게 바뀌었으면 잘 적용된 것이다!

문제

10진법 수 N이 주어진다. 이 수를 B진법으로 바꿔 출력하는 프로그램을 작성하시오.

10진법을 넘어가는 진법은 숫자로 표시할 수 없는 자리가 있다. 이런 경우에는 다음과 같이 알파벳 대문자를 사용한다.

A: 10, B: 11, ..., F: 15, ..., Y: 34, Z: 35


입력

첫째 줄에 N과 B가 주어진다. (2 ≤ B ≤ 36) N은 10억보다 작거나 같은 자연수이다.


출력

첫째 줄에 10진법 수 N을 B진법으로 출력한다.


예제 입력 예제 출력
60466175 36 ZZZZZ

풀이

10진법수 K를 N진법 수로 변환하는 방법은 K를 N으로 나눈 나머지를 역순서대로 배열하는 것이다.


코드

import java.util.Scanner;

public class Main {
    public static void main(String[] args) {
        Scanner sc = new Scanner(System.in);
        String line = sc.nextLine();
        String[] temp = line.split(" ");
        int n = Integer.parseInt(temp[0]);
        int m = Integer.parseInt(temp[1]);
        String[] array = {
                "0", "1", "2", "3", "4", "5", "6", "7", "8", "9",
                "A", "B", "C", "D", "E", "F", "G", "H", "I", "J",
                "K", "L", "M", "N", "O", "P", "Q", "R", "S", "T",
                "U", "V", "W", "X", "Y", "Z"
        };

        String answer = "";

        while(n/m>0){
            n=n/m;
            answer += array[n%m];
        }
        answer += array[n%m];

        System.out.println(answer);

    }
}

+ Recent posts